래블업에서 AI:GO라는 Personal Agentic AI Platform을 출시했습니다. Personal Agentic AI Platform의 핵심은 개인 PC에서 여러 AI 에이전트로 구성된 AI Squad를 쉽게 만들고 실행할 수 있다는 것입니다.
AI:GO는 go.backend.ai에서 macOS, Windows, Linux용을 모두 무료로 내려받을 수 있습니다. 내 컴퓨터 하드웨어에서 모델을 구동하고, 민감한 데이터 역시 같은 장소에서 제어할 수 있는 것이 기본 설계입니다. 또한 AI Squad라고 불리는 Agentic AI 기능을 제공하는데, 에이전틱 AI 기능을 실행하려면 여러 LLM을 안정적으로 실행하고 관리할 수 있어야 하기 때문에 AI:GO는 AI Squad 기능만 제공하는 것이 아니라 LLM 서빙 엔진이 갖춰야 할 기본 기능부터 함께 제공합니다.
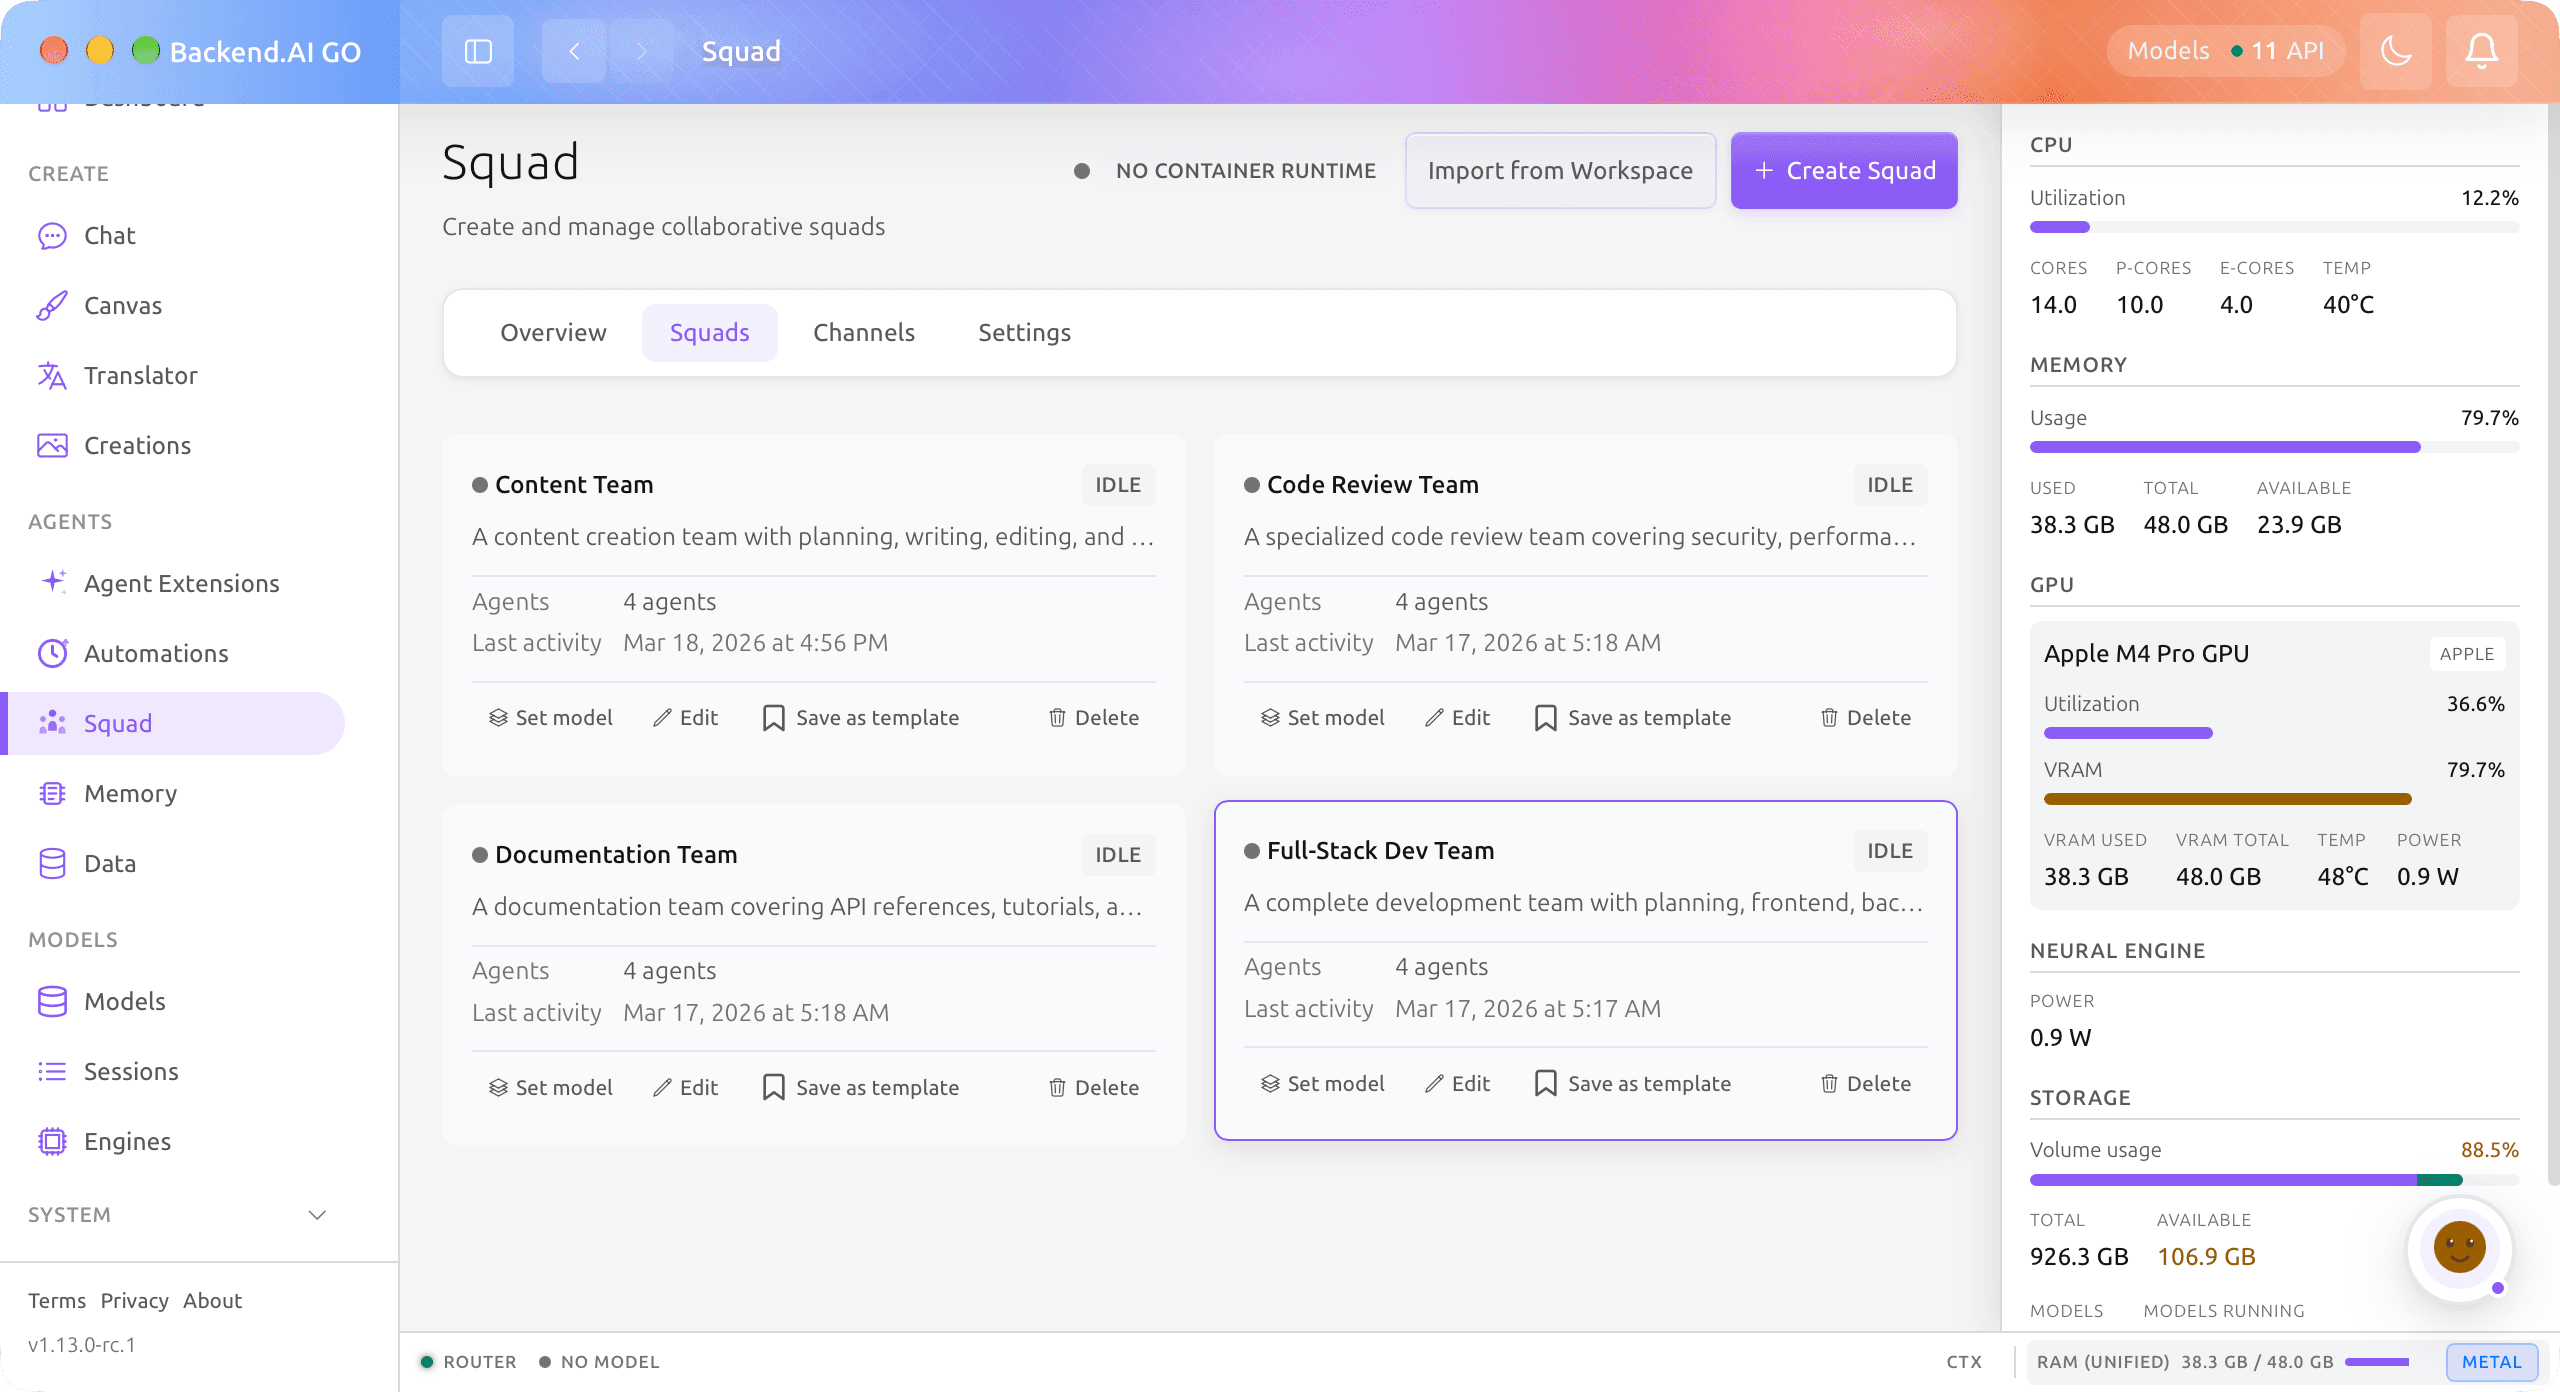
LLM 서빙 엔진의 기본 기능
LLM 서빙 엔진의 기본 역할은 LLM 모델을 이용해 추론한 결과를 반환하는 것입니다. 그러나 서빙 엔진만으로는 편리한 사용을 담보할 수 없습니다. 단순히 추론만 하는 것이 아니라, 모델을 쉽게 찾고 내려받을 수 있어야 하고, 같은 모델이라도 모델 크기, 양자화 방식, 컨텍스트 길이 등에 따라 여러 버전이 있기 때문에 설치된 모델과 파일을 관리하는 기능도 필요합니다. 또한 요즘은 GGUF (로컬LLM에서 많이 사용하는 방식)나 Safetensors (Apple Silicon이나 GPU 서버에서 사용하는 방식), CKPT (이미지 생성 모델에서 주로 사용하는 방식) 등 다양한 형식을 지원해야 합니다.
실행 환경에 맞는 추론 엔진도 필요합니다. 예를 들어 CPU에서 모델을 실행하거나 일반적인 PC에서 실행하는 경우에는 llama.cpp를 사용할 수 있어야 하고, Apple Silicon에서는 훨씬 좋은 성능을 내는 MLX 계열 모델을 사용할 수 있는 엔진을 선택할 수 있는 등 입니다. 고성능 NVIDIA GPU에서 동시 처리량이 중요하다면 vLLM이나 SGLang 같은 엔진이 적합할 수 있기에, 다양한 엔진을 지원하는 것 또한 중요한 부분 중 하나입니다.
사용자가 목적에 따라 다양한 모델을 내려받을 수 있기 때문에 여러 모델을 필요에 따라 바꿔 사용할 수 있어야 하며, 외부 프로그램에서 모델을 호출할 수 있도록 OpenAI 호환 API도 제공해야 합니다. AI:GO는 이 기능들을 하나의 데스크톱 애플리케이션에 모아 놓았습니다.
| 구분 | 주요 기능 |
|---|---|
| 모델 관리 | 모델 검색, 다운로드, 설치, 삭제 |
| 모델 형식 | GGUF, Safetensors 등 지원 |
| 추론 엔진 | 하드웨어에 맞는 엔진 선택 |
| 멀티모델 | 여러 모델 설치와 실행 상태 관리 |
| 사용자 인터페이스 | 모델 선택과 채팅 |
| 외부 연동 | OpenAI 호환 API |
| 상태 관리 | 메모리 사용량과 모델 실행 상태 확인 |
여러 모델과 추론 엔진 지원
AI:GO는 GGUF, Safetensors 등 다양한 모델 형식을 지원합니다. GGUF 모델은 llama.cpp로 실행할 수 있고, Apple Silicon에서는 mlx-lm이나 Lablup에서 개발한 MLXcel을, 이미지 생성에는 stable-diffusion.cpp를 사용할 수 있도록 준비되어 있습니다. 아래 표를 통해 AI:GO가 지원하는 추론 엔진과 실핸 환경을 살펴볼 수 있습니다.
| 추론 엔진 | 모델 형식 | 주요 실행 환경 |
|---|---|---|
| llama.cpp | GGUF | CPU, NVIDIA·AMD·Intel GPU, Apple Silicon |
| MLX LM | Safetensors, GGUF | Apple Silicon |
| MLXcel | Safetensors | Apple Silicon |
| stable-diffusion.cpp | Safetensors, CKPT, GGUF | 이미지 생성 |
| vLLM | Safetensors, AWQ, GPTQ 등 | NVIDIA GPU |
현재 vLLM 서버는 백엔드로 연결해 사용할 수 있으며, SGLang 등 OpenAI 호환 서버도 연결할 수 있습니다.
로컬 모델뿐만 아니라 OpenAI, Anthropic, Gemini와 OpenAI 호환 API도 연결할 수 있기때문에, 작업에 따라 로컬 모델과 클라우드 모델을 함께 사용할 수도 있습니다.
기존 LLM 서빙 엔진과 비교
로컬 LLM을 개인 PC에서 실행할 때는 Ollama가 많이 사용됩니다. 서버 환경에서 많은 요청을 처리해야 할 때는 vLLM이나 SGLang을 주로 사용합니다. AI:GO도 모델을 내려받고 실행한다는 점에서는 이들과 비슷하지만, 제품이 다루는 범위는 조금 다릅니다.
| 구분 | AI:GO | Ollama | vLLM | SGLang |
|---|---|---|---|---|
| 핵심 성격 | Personal Agentic AI Platform | 로컬 모델 실행 도구 | 고성능 추론 엔진 | 고성능 추론 프레임워크 |
| 주요 대상 | 개인, 개발자 | 개인, 개발자 | 서버, 프로덕션 서비스 | 서버, 대규모 추론 |
| 모델 검색·다운로드 | 지원 | 지원 | 별도 관리 | 별도 관리 |
| 여러 모델 관리 | 지원 | 지원 | 모델별 서버 중심 | Gateway 구성 가능 |
| 여러 추론 엔진 관리 | 지원 | 미지원 | 미지원 | 미지원 |
| 로컬 채팅 UI | 지원 | 지원 | 별도 UI 필요 | 별도 UI 필요 |
| 클라우드 모델 연결 | 지원 | Ollama Cloud 중심 | 직접 지원하지 않음 | Gateway 구성 가능 |
| OpenAI 호환 API | 지원 | 지원 | 지원 | 지원 |
| Tool Calling | 지원 | 지원 | 지원 | 지원 |
| 도구 실행 루프 | 지원 | 외부 프로그램 필요 | 별도 구현 필요 | 구성에 따라 지원 |
| MCP 연동 | 지원 | 외부 프로그램 필요 | Tool Server 구성 | Gateway에서 지원 |
| 멀티에이전트 협업 | AI Squad 제공 | 별도 프레임워크 필요 | 별도 프레임워크 필요 | 별도 구성 필요 |
vLLM과 SGLang은 GPU를 효율적으로 사용하면서 많은 추론 요청을 처리하는 것에 집중하고 있고, Ollama는 로컬 모델을 간단히 내려받고 실행하는 데 초점을 맞추고 있습니다. AI:GO는 여러 모델과 추론 엔진을 관리하고, 그 위에서 에이전트와 AI Squad를 실행하는 데 초점이 맞춰져 있습니다.
모델 서빙에서 에이전트 실행으로
모델이 Tool Calling을 지원한다고 해서 도구가 자동으로 실행되는 것은 아닙니다. 모델은 어떤 도구를 어떤 인자로 호출할지 반환할 뿐, 실제 프로그램이 이를 해석해 도구를 실행하고 실행 결과를 모델에 다시 전달해야 합니다. 모델이 결과를 확인한 뒤 다음 작업을 결정하려면 이 과정을 반복하는 Agent Loop도 필요합니다.
Ollama나 vLLM을 사용할 때는 보통 이 부분을 별도 프로그램이나 에이전트 프레임워크에서 구현하지만, AI:GO는 도구 실행과 Agent Loop를 애플리케이션 안에서 처리합니다. 내장 에이전트가 보안이 적용된 로컬 샌드박스 안에서 파일 편집부터 코드 실행까지 자연스럽게 거듭니다. MCP 서버도 연결할 수 있어 파일 시스템, 데이터베이스, 외부 API나 사용자가 만든 도구를 에이전트에서 사용할 수 있습니다.
에이전트마다 역할도 다르게 지정할 수 있습니다.
- 사용할 모델
- 시스템 프롬프트
- 사용할 수 있는 도구
- 도구별 실행 권한
- 최대 토큰과 실행 제한
여기까지는 한 개의 에이전트를 실행하는 데 필요한 기능입니다. AI:GO는 여기서 한 단계 더 나아가 여러 에이전트를 하나의 팀으로 묶는 AI Squad를 제공합니다.
AI:GO의 핵심, AI Squad
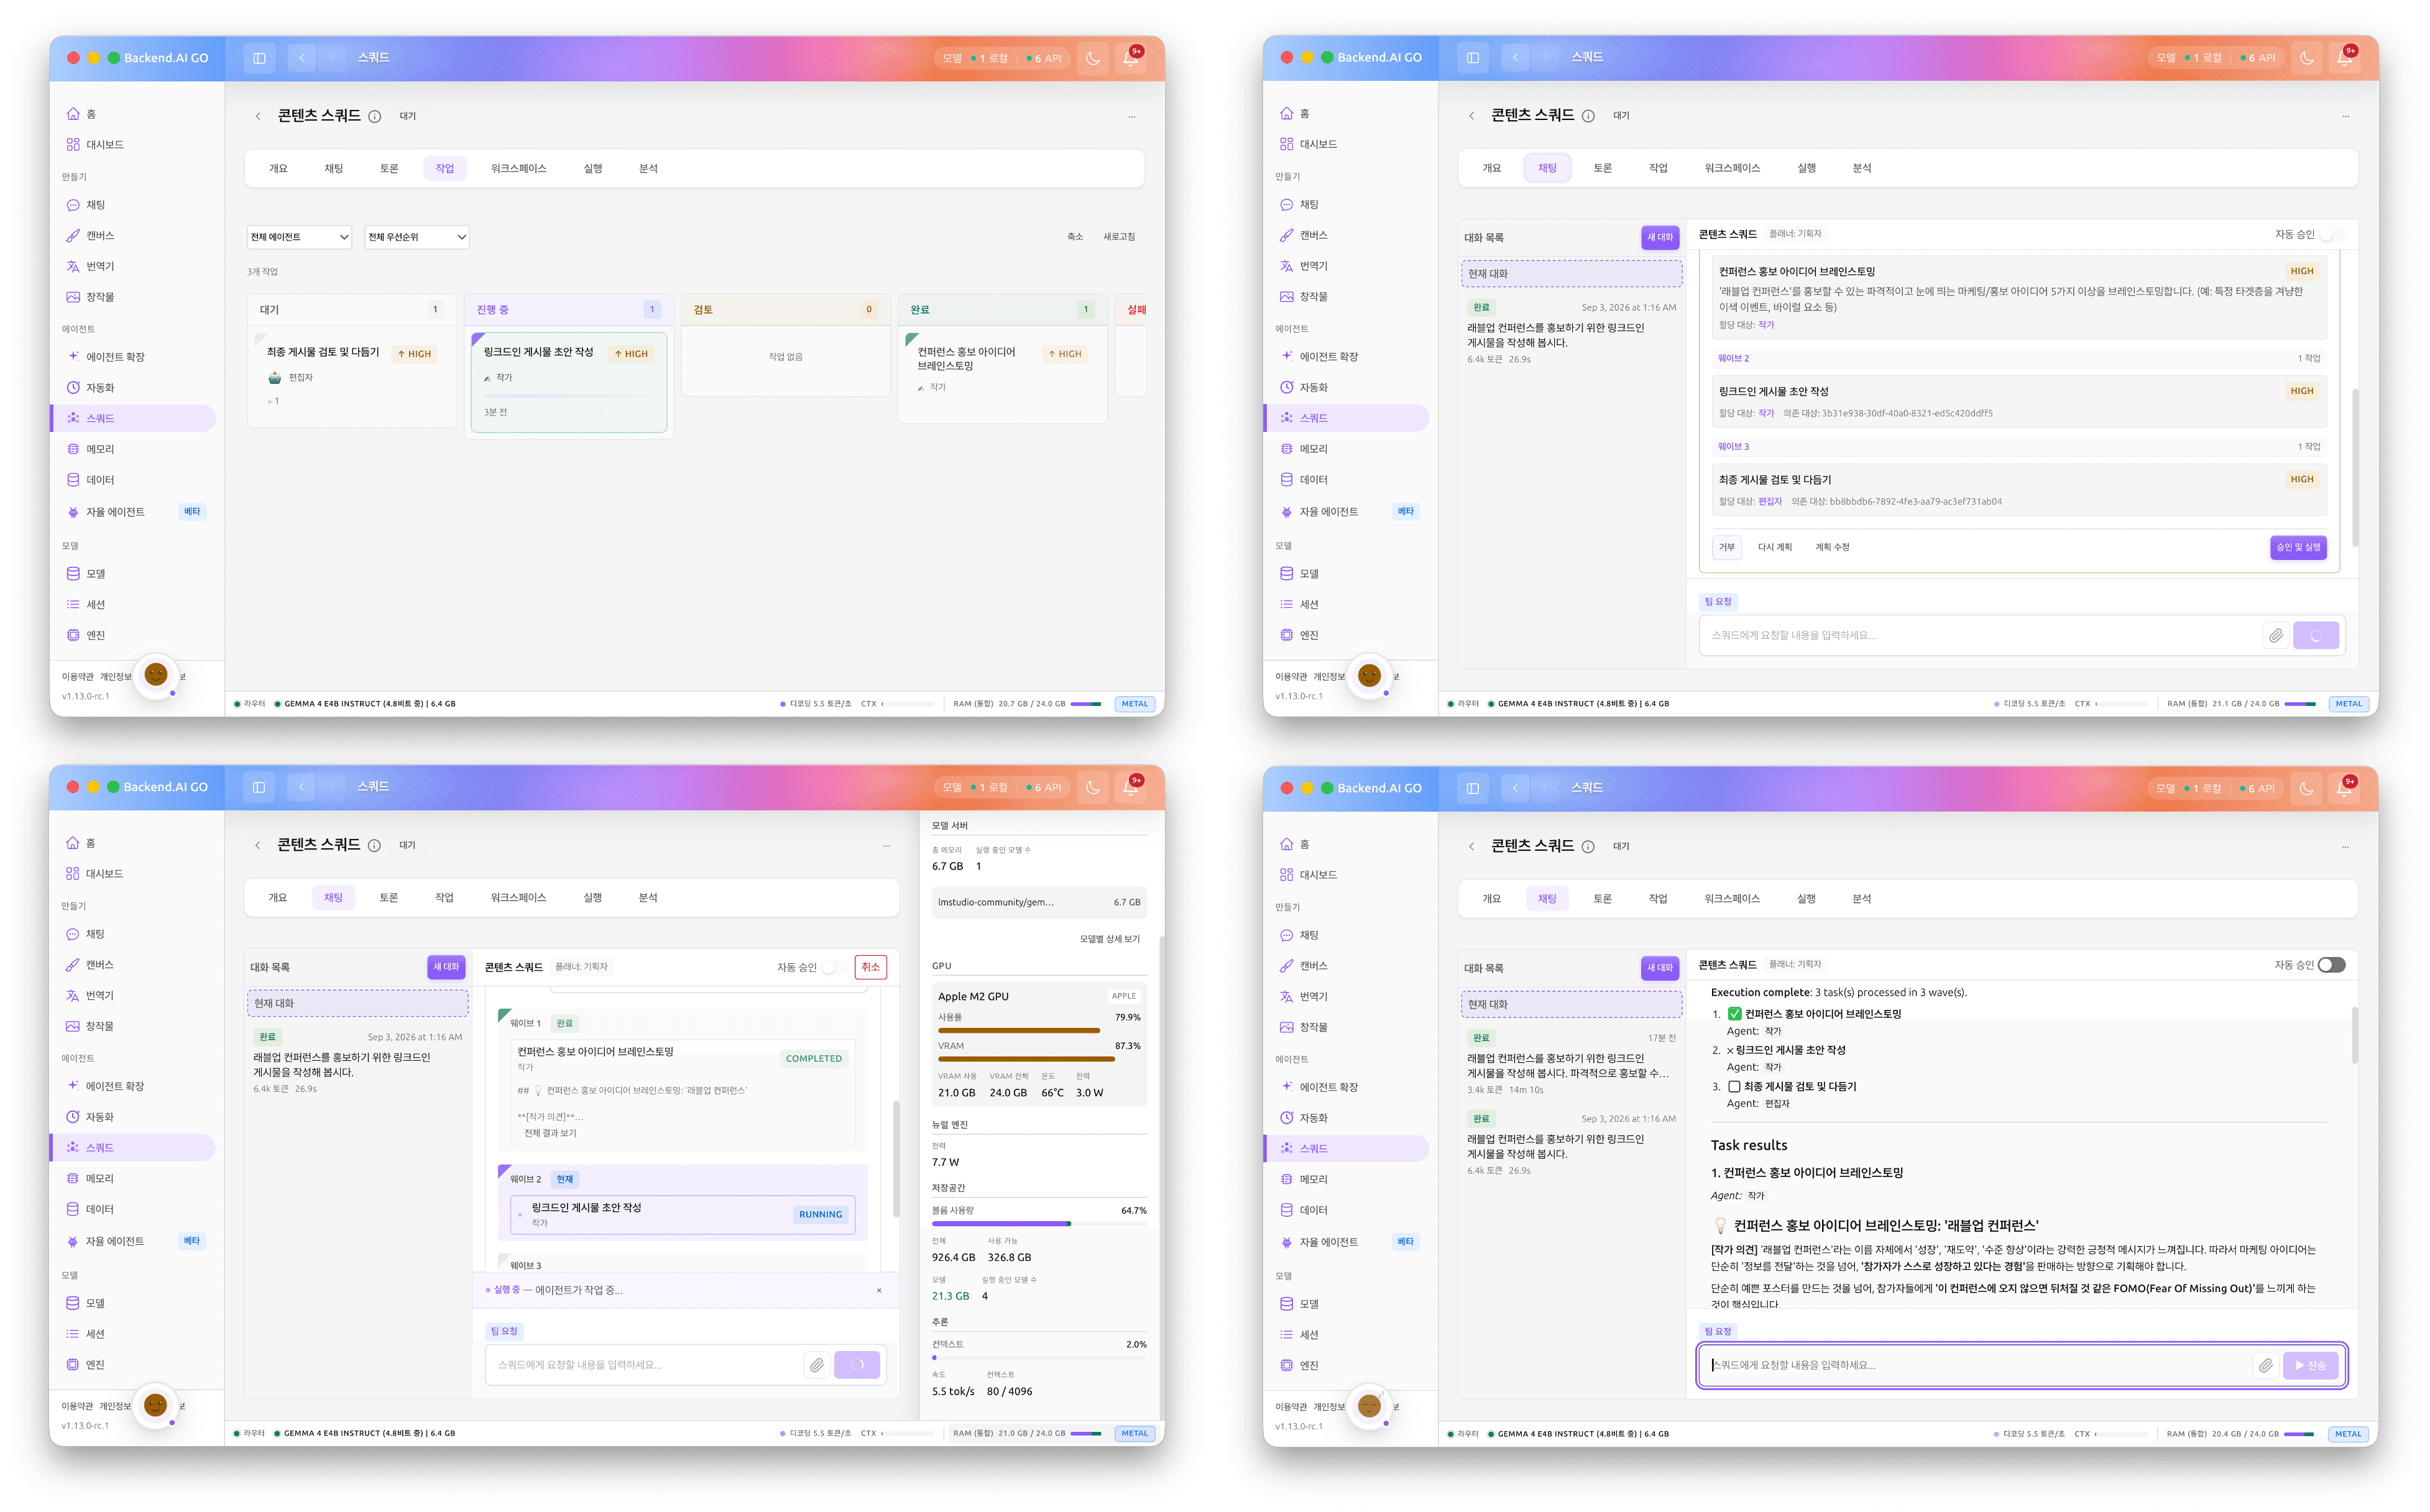
AI Squad는 역할이 다른 여러 에이전트가 작업을 나누어 수행하는 기능입니다. 예를 들어 기술 문서를 작성하는 Squad를 다음과 같이 구성할 수 있습니다.
| 에이전트 | 역할 |
|---|---|
| 리서처 | 관련 자료와 근거 수집 |
| 분석가 | 수집한 자료의 의미와 장단점 분석 |
| 작성자 | 분석 결과를 문서로 정리 |
| 리뷰어 | 사실관계와 논리 검토 |
| 오케스트레이터 | 작업 분배와 결과 취합 |
각 에이전트에는 서로 다른 모델을 지정할 수 있습니다.
간단한 자료 분류에는 작은 로컬 모델을 사용하고, 복잡한 분석에는 추론 성능이 좋은 모델을 사용할 수 있습니다. 외부로 보내기 어려운 자료는 로컬 모델이 처리하고, 필요한 일부 작업만 클라우드 모델에 맡기는 구성도 가능합니다.
에이전트별로 사용할 수 있는 도구와 권한도 따로 지정할 수 있습니다. 자료를 찾는 에이전트에는 검색 도구를 주고, 문서를 작성하는 에이전트에는 파일 생성 권한을 주는 식입니다.
Squad에서 발생한 작업은 태스크 보드에서 확인할 수 있습니다. 태스크별 담당 에이전트와 진행 상태, 다른 태스크와의 의존성, 결과와 오류를 볼 수 있습니다. 에이전트가 만든 파일은 공유 워크스페이스에 저장되므로 다른 에이전트가 이어서 사용하거나 사용자가 직접 확인할 수 있습니다.
에이전트끼리 특정 주제를 토론하도록 구성할 수도 있습니다. 사회자 역할의 에이전트가 발언 순서와 진행을 관리하거나, 여러 에이전트가 차례대로 의견을 내면서 앞선 내용을 발전시키는 방식입니다.
중요한 것은 단순히 여러 채팅 세션을 동시에 실행하는 것이 아닙니다. 작업을 나누고, 담당 에이전트를 지정하고, 중간 결과를 공유하고, 다른 에이전트가 그 결과를 이어받는 과정까지 포함됩니다.
Personal Agentic AI Platform
AI:GO는 에이전트마다 작업에 적합한 모델을 지정하고, 필요한 도구와 권한을 설정한 뒤, 여러 에이전트를 하나의 Squad로 구성하기 위한 기반을 제공합니다.
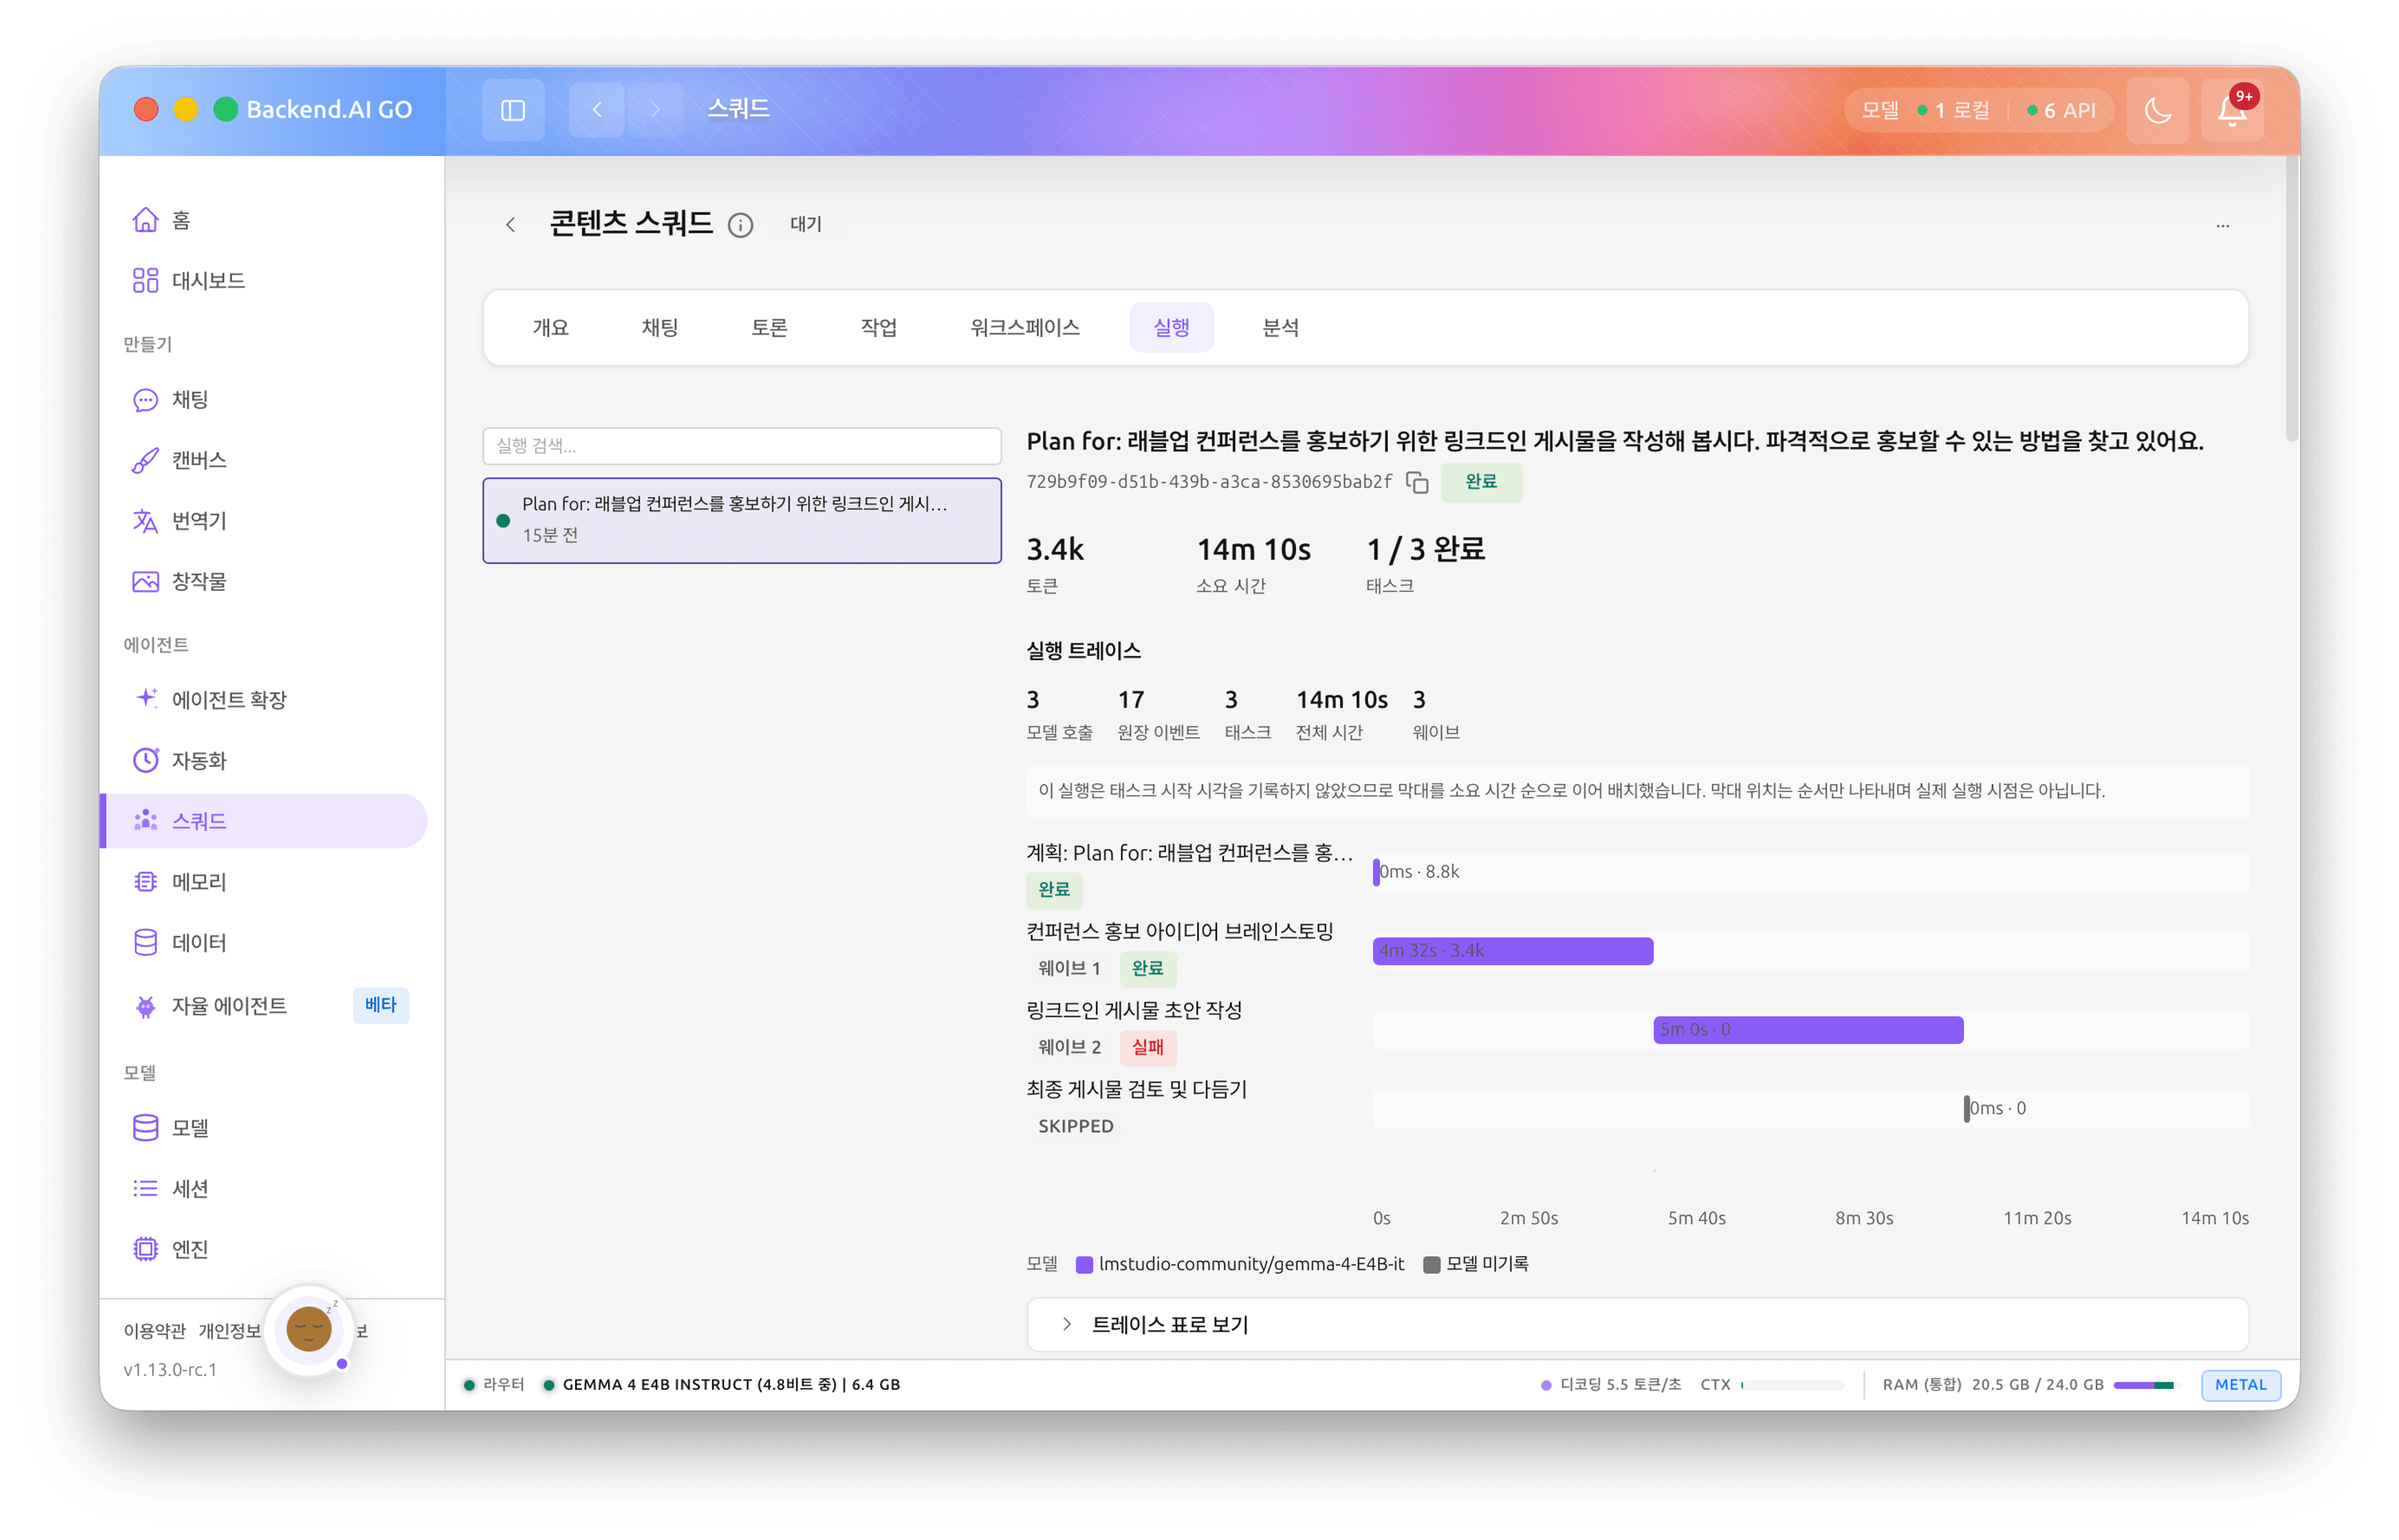
기존 LLM 서빙 엔진을 이용해서도 AI Squad를 만들 수 있습니다. 다만 모델 서버와 에이전트 프레임워크를 연결하고, 도구 실행과 에이전트 간 작업 전달, 공유 워크스페이스와 실행 상태 관리 등을 직접 구성해야 합니다.
AI:GO는 이 과정을 데스크톱 애플리케이션 안에서 제공합니다.
노트북 한 대에서 시작해, 필요해지면 같은 네트워크의 여러 GO를 엮어 사무실 전체를 GO Mesh로 자연스럽게 넓힐 수 있습니다. 성능 좋은 장비 한 대가 다른 장치들을 도우며 더 넓은 작업 공간이 되고, 더 큰 환경이 필요하면 Backend.AI로 바로 확장할 수 있습니다.
개인이 자신의 컴퓨터에서 여러 모델을 실행하고, 모델을 에이전트로 구성하고, 여러 에이전트를 하나의 AI Squad로 편성할 수 있게 하는 것. 이것이 AI:GO에서 말하는 Personal Agentic AI Platform입니다.
