
Backend.AI Slurm Frontend는 기존 Slurm 명령과 작업 흐름을 유지하면서 워크로드를 Backend.AI에서 실행할 수 있게 해 주는 기능입니다. 연구자는 지금처럼 sbatch, srun, squeue를 사용하고, 제출한 작업은 Backend.AI GPU 플랫폼의 격리된 컨테이너에서 실행됩니다.
Slurm과 Backend.AI의 강점
Slurm은 세계 슈퍼컴퓨터 상당수가 사용하는 오픈소스 워크로드 매니저입니다. 중앙 컨트롤러가 작업을 대기열에 넣고 파티션(partition)으로 묶인 연산 노드에 스케줄링하면, 각 노드의 데몬은 작업을 실행하고, 어카운팅 서비스는 작업 이력을 기록합니다. Slurm은 대규모 배치 작업 처리에 강점이 있습니다. 계정, 서비스 품질(QoS), 공정 배분(fair-share)을 아우르는 세밀한 정책도 지원합니다. 무엇보다 HPC 분야에서 널리 쓰이는 명령줄 인터페이스를 갖추고 있어, 많은 연구자와 운영자에게 익숙합니다.
Backend.AI는 래블업이 만드는 AI·HPC용 오픈소스 컨테이너 플랫폼입니다. Backend.AI에서 모든 워크로드는 세션(session) 단위로 실행되며, 세션은 이미지에서 생성한 하나 이상의 컨테이너로 구성되고 Backend.AI의 Sokovan 오케스트레이터가 GPU 노드에 배치합니다. 관리형 스토리지 폴더에는 쿼터가 적용되고, 프로젝트와 정책 단위의 멀티테넌시도 지원됩니다. Jupyter나 VS Code, SSH 같은 대화형 도구와 사용자와 관리자를 위한 웹 콘솔도 함께 제공합니다.
Backend.AI가 지원하는 가속기는 NVIDIA·AMD GPU부터 Intel Gaudi, Google TPU, 여러 NPU까지 다양합니다. NVIDIA GPU에서는 컨테이너 수준 GPU 가상화(Container-level GPU Virtualization)를 통해 GPU 한 장을 여러 워크로드에 나누어 할당할 수 있습니다.
| 구분 | Slurm | Backend.AI |
|---|---|---|
| 작업 단위 | 공유 호스트에서 실행되는 작업(job) | 전용 컨테이너에서 실행되는 세션 |
| 소프트웨어 환경 | 공유 OS와 모듈 트리(컨테이너는 추가 기능) | 워크로드별 컨테이너 이미지 |
| 대화형 작업 | 자원 할당과 터미널 | 노트북, IDE, SSH, 웹 터미널 기본 제공 |
| GPU 공유 | 장치 단위 할당 또는 벤더 공유 기능 | NVIDIA GPU 분할 할당 기본 제공 |
| 스토리지 | 사이트가 관리하는 공유 파일시스템 | 소유자, 공유 범위, 쿼터가 지정된 관리형 폴더 |
| 사용 현황 확인 | 명령줄 보고서 | 사용자별, 클러스터 전체 사용량을 보여 주는 웹 콘솔 |
| 생태계 | HPC의 사실상 표준 인터페이스 | REST API, GraphQL API, SDK |
Slurm에서 다른 플랫폼으로 전환하기 어려운 이유
HPC와 AI 인프라를 운영하는 팀은 컨테이너 플랫폼의 다양한 기능을 필요로 합니다. 사용자별로 격리된 소프트웨어 환경, GPU 공유, 사용자가 직접 관리할 수 있는 스토리지, 자원 사용 현황을 한눈에 확인할 수 있는 대시보드 등이 대표적입니다. 하지만 이런 기능이 필요하다고 해서 기존 플랫폼을 곧바로 바꾸기는 어렵습니다.
각 사용자가 수년간 작성한 작업 스크립트와 작업 제출용 래퍼, 워크플로 엔진, MPI 실행 스크립트, 어카운팅 보고서, 모니터링 훅은 모두 기존 스케줄러를 전제로 만들어졌습니다. 이들은 sbatch, srun, squeue, sacct가 존재하고, 지금까지와 같은 방식으로 동작한다고 가정합니다. 기존 Slurm 환경을 다른 플랫폼으로 대체하려면 이러한 의존성을 하나씩 파악하고, 관련 코드를 수정한 뒤 다시 검증해야 합니다. 많은 운영 기관에서 이 마이그레이션 과정은 플랫폼 전환 중 비용과 위험이 가장 큰 단계입니다. 필요한 기능이 Slurm의 범위를 넘어섰어도, 전환 부담 때문에 기존 환경을 계속 운영하는 경우가 많은 이유입니다.
Slurm 인터페이스는 유지하고 실행 기반은 Backend.AI로
Slurm Frontend는 Slurm의 중앙 작업 컨트롤러와 어카운팅 서비스를 대신합니다. Slurm 네트워크 프로토콜과 출력 형식을 구현하므로, 사용자는 로그인 노드에서 기존 Slurm 명령을 그대로 사용할 수 있습니다. 대신 내부에서는 Slurm 스케줄러와 연산 노드 데몬을 실행하지 않습니다. Slurm Frontend가 각 요청을 Backend.AI의 해당 기능으로 변환하고, 실제 스케줄링과 작업 격리, 스토리지 관리, 사용량 기록은 Backend.AI가 처리합니다.
설계 원칙은 다음과 같습니다.
1. 로그인 노드에서는 바뀌는 것이 없습니다. 로그인 노드의 Slurm 클라이언트는 배포판 패키지로 설치한 표준 클라이언트입니다. 바뀌는 것은 클라이언트의 접속 대상뿐이며, 클라이언트는 Slurm 컨트롤러 대신 Slurm Frontend에 접속합니다.
2. 스케줄링 결정과 자원, 작업 상태는 모두 Backend.AI에서 관리합니다. Slurm Frontend는 Slurm의 작은 정수형 작업 ID처럼 Slurm 사용자가 기대하지만 Backend.AI에는 없는 정보만 따로 기록합니다.
3. 지원하지 않는 기능은 제출 단계에서 거절됩니다. Backend.AI에서 대응할 수 있는 Slurm 기능의 경우 원래 명령어가 가진 의미 그대로 변환됩니다. Backend.AI에 정확한 대응 기능이 존재하지 않는 경우에는 사용자의 의도와 다른 작업이 실행되지 않도록 작업의 접수를 차단하고, 정식 Slurm 오류를 반환합니다.
아키텍처
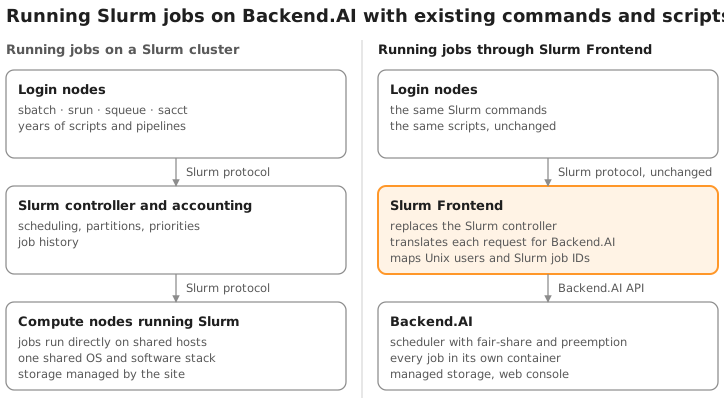
▲ 기존 Slurm 클러스터(왼쪽)와 Slurm Frontend를 적용한 Backend.AI 구성(오른쪽)
그림 맨 위의 로그인 노드는 기존 구성을 유지합니다. 같은 Slurm 명령을 사용하고, 같은 Slurm 프로토콜로 통신하기 때문입니다. 중앙의 컨트롤러와 어카운팅 서비스는 Slurm Frontend가 대체하고, 하단의 연산 노드에서는 Backend.AI가 작업 실행을 담당합니다.
사용자 요청은 Slurm 프로토콜 계층과 변환 계층을 거쳐 Backend.AI로 전달됩니다.
1. Slurm 프로토콜 계층이 로그인 노드의 명령을 받습니다. 기존 환경에서 사용하는 Munge 인증으로 요청자를 확인하고, Slurm 컨트롤러와 같은 방식으로 요청을 해석합니다. 여러 Slurm 릴리스의 프로토콜을 동시에 지원하므로, 클라이언트마다 해당 버전에 맞는 프로토콜로 응답합니다.
2. 변환 계층이 Slurm 개념을 Backend.AI 개념에 연결합니다. 작업은 세션에, 파티션은 자원 그룹에, Unix 사용자는 해당 Backend.AI 계정에 연결합니다. Slurm 작업 ID와 Backend.AI 세션의 대응 관계처럼 Slurm 인터페이스에 필요한 상태 정보도 이 계층에서 보관하고, 백그라운드에서 Backend.AI와 지속적으로 동기화합니다.
3. Backend.AI가 작업을 배치하고 실행합니다. 작업을 스케줄링해 GPU 노드에서 컨테이너를 시작하고, 스토리지 마운트와 사용량 기록도 처리합니다. 처리 결과는 앞선 계층을 거쳐 Slurm 명령이 기대하는 형식으로 반환됩니다.
대화형 작업도 같은 방식으로 처리됩니다. srun과 srun --pty bash는 사용자 터미널을 작업 컨테이너 내부의 실제 셸에 연결합니다. 터미널 입출력과 창 크기 조절, 종료 코드도 기존 Slurm 환경과 같은 방식으로 처리됩니다.
주요 기능
Slurm Frontend를 사용하면 기존 Slurm 작업 흐름을 유지하면서 Backend.AI의 실행 환경과 운영 기능을 활용할 수 있습니다.
Slurm 작업 흐름과 파티션
일상적인 Slurm 작업 흐름은 바뀌지 않습니다. sbatch의 배치 작업 제출은 job array와 작업 의존성, 시작 시각을 미룬 작업, 보류(hold)한 작업까지 지원됩니다. salloc은 대화형 자원을 할당하고, srun은 대화형 셸과 명령을 실행합니다. 대기열과 클러스터 상태 조회(squeue, sinfo, scontrol), 작업 취소(scancel), 작업 이력 조회(sacct)도 기존 명령으로 처리됩니다. 멀티노드 작업과 MPI 작업은 Backend.AI의 멀티노드 세션으로 실행됩니다.
Backend.AI의 자원 그룹은 Slurm 파티션으로 표시됩니다. 관리자는 팀의 프로젝트와 노드 풀을 묶은 파티션을 따로 정의하거나, Slurm 사이트에서 하던 것처럼 같은 하드웨어 위에 여러 파티션을 둘 수 있습니다.
파티션별 우선순위 단계(priority tier) 설정도 지원됩니다. 우선순위가 높은 작업이 자원을 기다리면 Backend.AI 스케줄러는 같은 노드에서 실행 중인 낮은 우선순위 작업을 중지해 자원을 확보합니다. Slurm 도구에서는 중지된 작업이 선점(preemption)된 작업으로 표시됩니다.
컨테이너 격리와 가속기 자원
모든 작업은 독립된 컨테이너 안에서 작업을 제출한 사용자의 Unix 계정으로 실행됩니다. 파일시스템과 프로세스도 작업별로 격리됩니다. 사용자는 작업마다 컨테이너 이미지를 지정할 수 있어, 서로 다른 소프트웨어 스택 간의 충돌을 피할 수 있습니다. Backend.AI는 현재 Docker와 Podman을 사용해 컨테이너를 실행합니다.
Slurm으로 요청한 GPU 자원은 Backend.AI의 GPU 풀에서 할당됩니다. NVIDIA GPU에서는 Backend.AI의 컨테이너 수준 GPU 가상화를 통해 Slurm 작업과 다른 Backend.AI 워크로드가 GPU 한 장을 나누어 사용할 수 있습니다.
HPC 환경에서는 작업을 격리하면서도 고속 데이터 전송 경로를 유지하는 것이 중요합니다. Backend.AI는 컨테이너로 격리된 작업에서도 이 경로를 사용할 수 있도록 실행 환경을 구성합니다. 작업에 할당할 CPU 코어와 가속기는 NUMA 구조를 고려해 서로 가까운 위치에 배치합니다. 고성능 I/O에 필요한 RDMA 장치 접근과 고정 메모리(pinned memory) 한도 해제도 컨테이너 설정에 미리 반영하며, 공유 메모리 크기는 작업에 맞게 설정합니다.
컨테이너는 노드의 InfiniBand와 RoCE 어댑터에 직접 접근합니다. 멀티노드 작업은 GPUDirect RDMA를 통해 GPU 간에 데이터를 주고받고, GPUDirect Storage는 작업별 격리를 유지하면서 지원되는 스토리지의 데이터를 GPU 메모리로 직접 읽어 들입니다. Slurm Frontend로 제출한 작업도 같은 컨테이너 환경에서 실행되므로, MPI와 NCCL 워크로드는 베어메탈 환경과 같은 하드웨어 데이터 경로를 사용합니다.
Backend.AI는 NVIDIA와 AMD GPU, Intel Gaudi, Google TPU, Graphcore IPU를 비롯해 리벨리온, 퓨리오사AI, HyperAccel, 텐스토렌트의 AI 가속기를 하나의 플러그인 방식 자원 모델로 스케줄링합니다. Slurm Frontend 환경에서는 같은 sbatch, srun 명령이 모든 가속기에 적용됩니다. 각 파티션을 서로 다른 가속기 풀에 연결할 수 있으며, 작업이 어떤 하드웨어에서 실행되든 Slurm 인터페이스는 유지됩니다.
사용자 계정과 스토리지
Slurm 표준 인증 방식인 Munge로 요청을 인증하고, 각 Unix 사용자를 해당 Backend.AI 계정에 연결합니다. 작업은 제출한 사용자 소유로 기록되며, 사용량은 해당 프로젝트에 집계됩니다. Backend.AI의 접근 제어 규칙과 쿼터도 동일하게 적용됩니다.
sshare는 Backend.AI 공정 배분 스케줄러가 계산한 fair-share 데이터를 보여 줍니다. sacct의 작업 이력은 실행이 끝난 세션이 정리된 뒤에도 남습니다.
Backend.AI 관리형 스토리지의 폴더는 모든 작업에 자동으로 마운트할 수 있습니다. scratch 영역이나 데이터셋 폴더 같은 공유 공간은 물론, 사용자별 영구 홈 디렉터리도 같은 방식으로 제공합니다. 작업별로 필요한 폴더를 추가로 요청할 수도 있습니다.
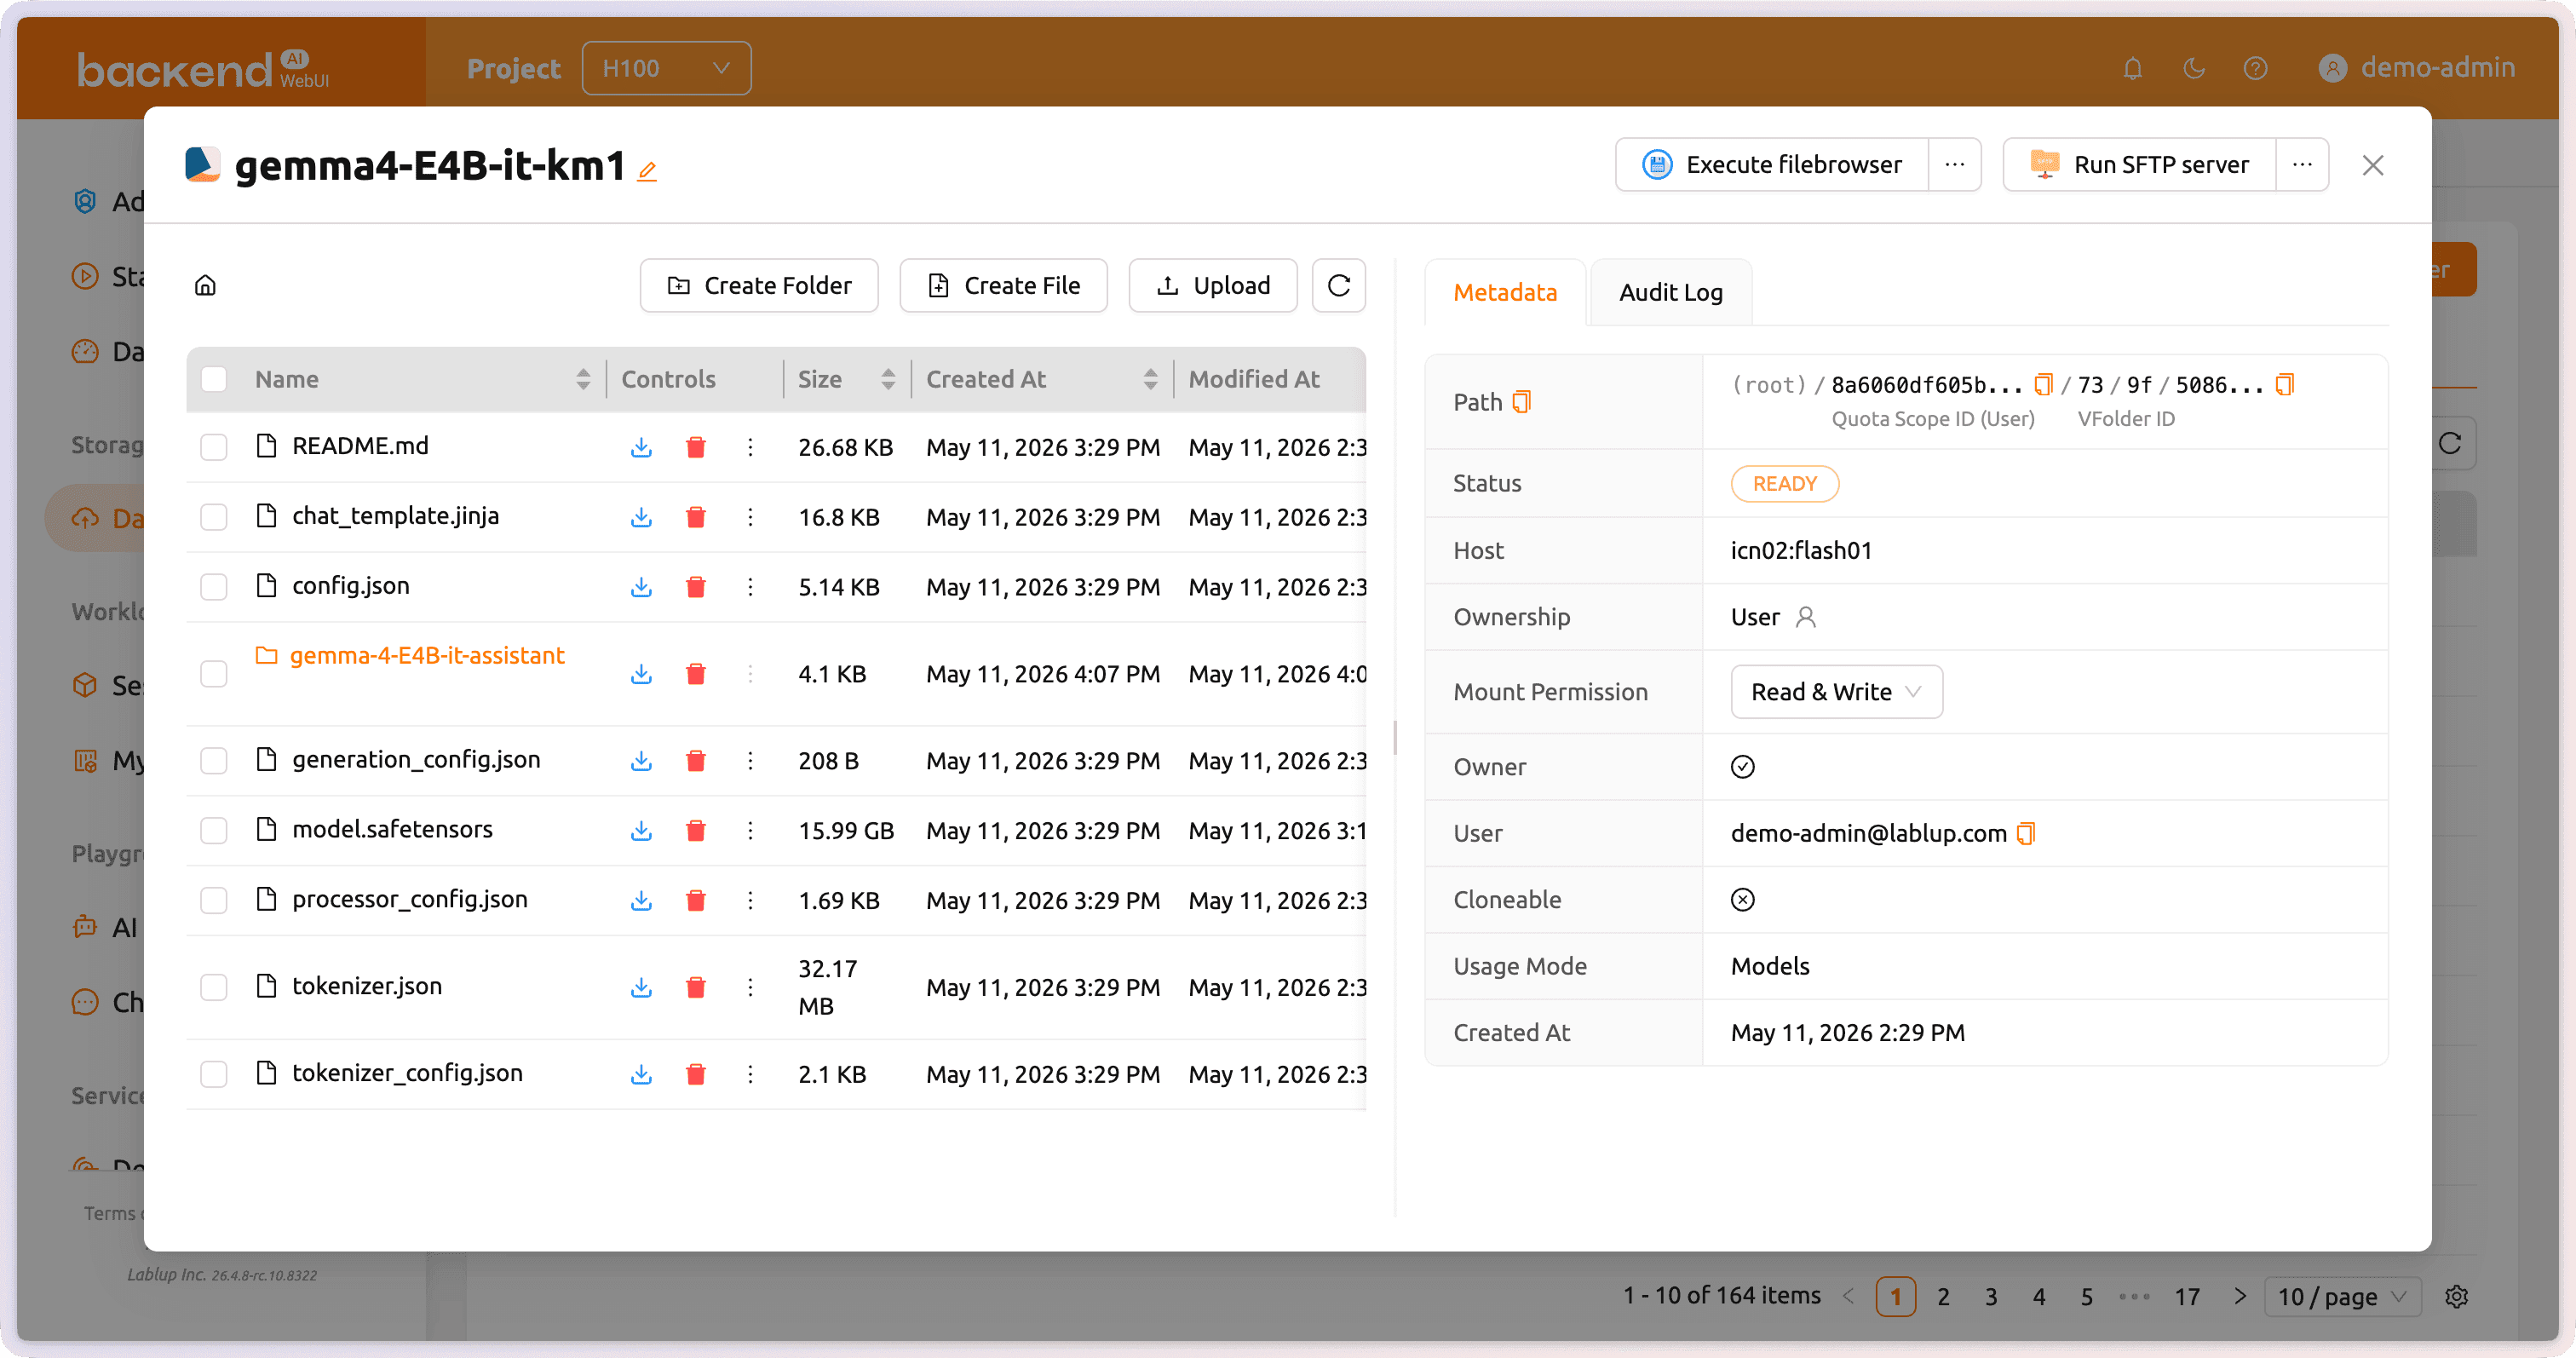
▲ Backend.AI WebUI의 관리형 스토리지. 모든 폴더에 소유자와 권한, 쿼터 범위가 지정되어 있습니다.
통합 웹 콘솔
Slurm 작업은 Backend.AI 세션으로 실행되므로, 웹 콘솔에서 다른 워크로드와 함께 확인할 수 있습니다. 사용자·프로젝트별 연산 자원과 스토리지 사용량, 클러스터 전체 모니터링 정보도 같은 콘솔에서 제공합니다.
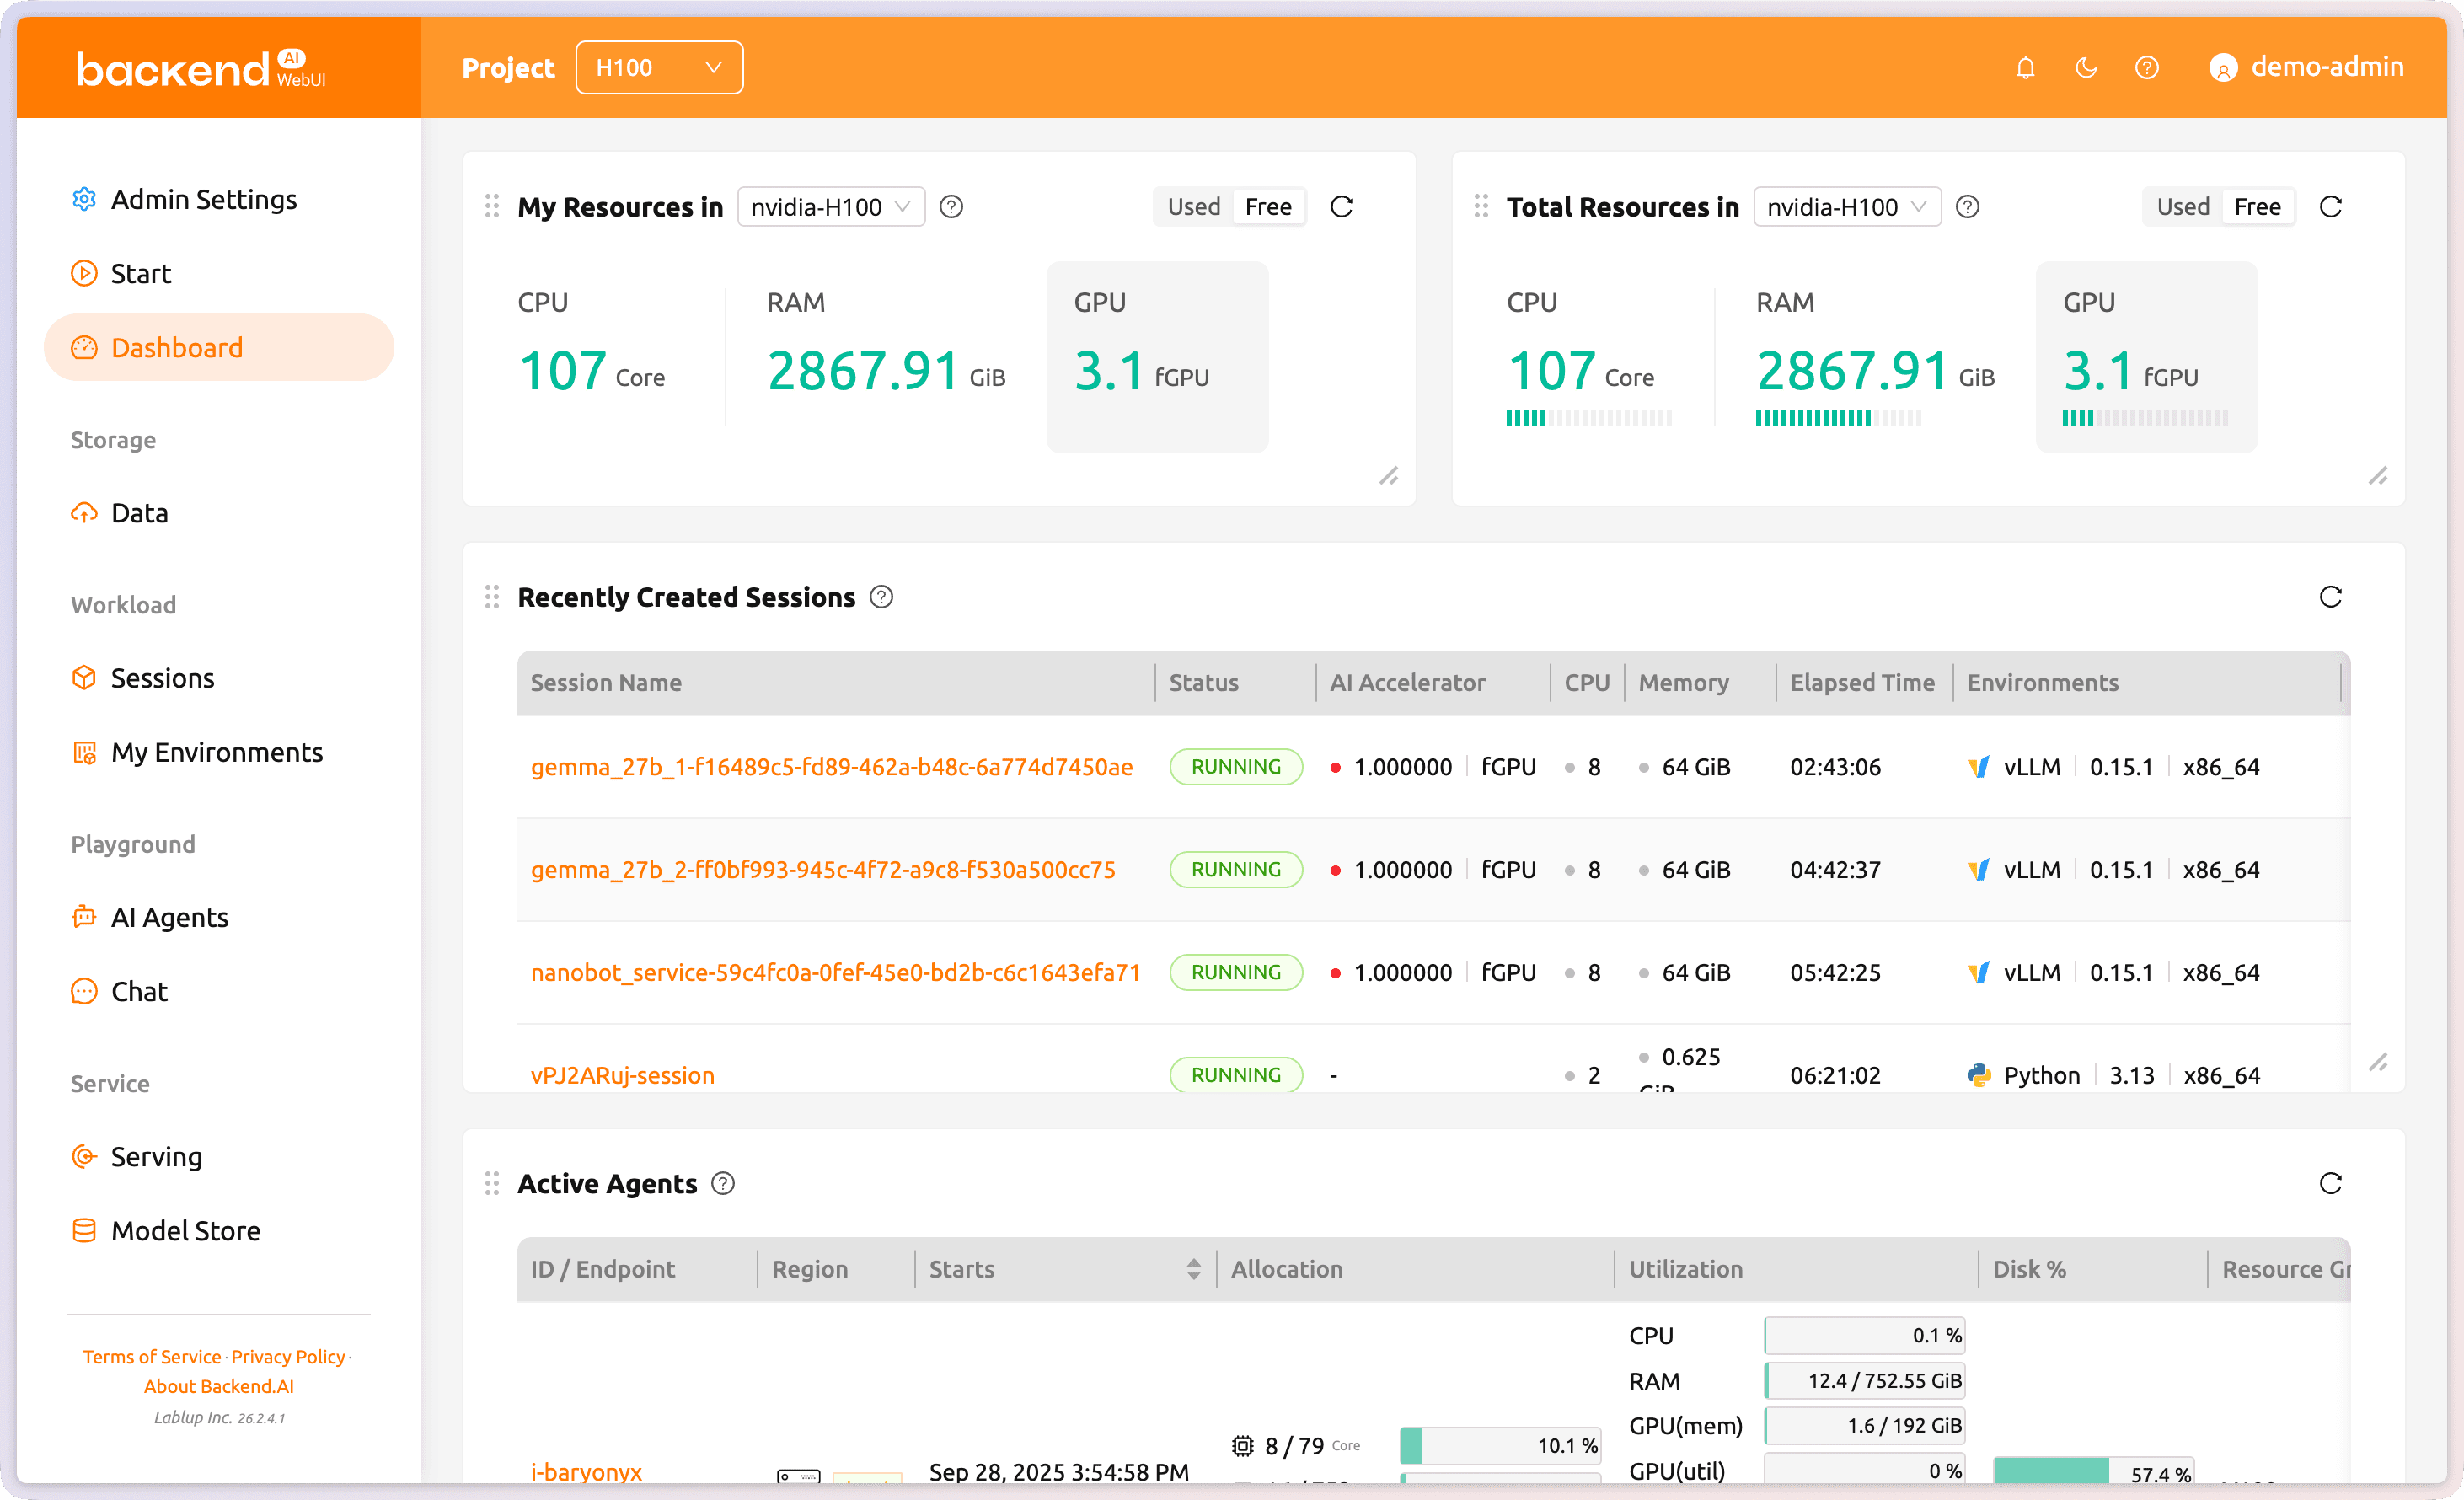
▲ Backend.AI 대시보드. 자원 그룹별 할당 자원과 전체 자원, 최근 세션, 에이전트별 실시간 사용률이 한 화면에 표시됩니다.
Slurm 개념과 Backend.AI 개념의 대응
Slurm의 주요 개념은 대부분 Backend.AI의 개념과 일대일로 대응합니다. 이러한 개념은 Slurm Frontend가 변환하므로, 사용자는 내부 변환 과정을 의식하지 않고 기존 명령을 사용할 수 있습니다.
| Slurm 개념 | Backend.AI 대응 |
|---|---|
배치 작업(sbatch) | 작업 스크립트를 실행하는 배치 세션 |
대화형 작업(salloc, srun) | 대화형 세션 |
작업 스텝(job step, 작업 안의 srun) | 작업 컨테이너 안에서 실행하는 명령 |
| 멀티노드 작업 | 여러 컨테이너로 구성된 멀티노드 세션 |
| 작업 ID | Slurm Frontend 보관, 세션과 대응 |
| 파티션 | 자원 그룹, 필요 시 프로젝트와 연결 |
| 연산 노드 | Backend.AI 에이전트 |
| GPU 요청(GRES) | 가속기 자원 슬롯, NVIDIA GPU는 분할 할당 포함 |
| Unix 사용자 | Unix ID가 같은 Backend.AI 사용자 |
| 공정 배분(fair-share) | Backend.AI 공정 배분 스케줄러 |
| 작업 이력 | 세션 이력과 Slurm Frontend 자체 기록 |
| 공유 파일시스템 | 작업마다 마운트되는 관리형 스토리지 폴더 |
| 소프트웨어 환경 | 컨테이너 이미지 |
역할별로 달라지는 점
연구자와 개발자는 Slurm 사용법을 새로 익힐 필요가 없습니다. 기존 작업 스크립트와 래퍼, 파이프라인이 그대로 동작하고, squeue를 입력하던 익숙한 습관도 바꿀 필요가 없습니다. 각 작업은 별도의 컨테이너 이미지로 실행됩니다. 한 팀의 CUDA 버전이나 컴파일러, Python 환경이 다른 팀의 실행 환경에 영향을 주지 않습니다. 사용자는 필요한 소프트웨어를 설치해 실험하고, 같은 소프트웨어 환경을 Backend.AI의 대화형 노트북이나 IDE 세션에서도 사용할 수 있습니다.
인프라 운영자는 사용자 인터페이스를 유지하면서 실행 플랫폼을 Backend.AI로 전환할 수 있습니다. Slurm 환경 전환에서 큰 부담이었던 기존 파이프라인의 수정과 재검증 작업도 상당 부분 줄일 수 있습니다. 사용자·프로젝트별 연산 자원과 스토리지 사용량, 쿼터, 클러스터 전체 모니터링도 보고서 스크립트 모음 대신 그래픽 콘솔로 제공됩니다. 배치 HPC 작업과 대화형 개발, 다른 AI 워크로드는 별도 환경으로 나뉘지 않습니다. 모든 워크로드가 같은 노드와 GPU 풀, 스케줄러 정책, 스토리지를 공유합니다.
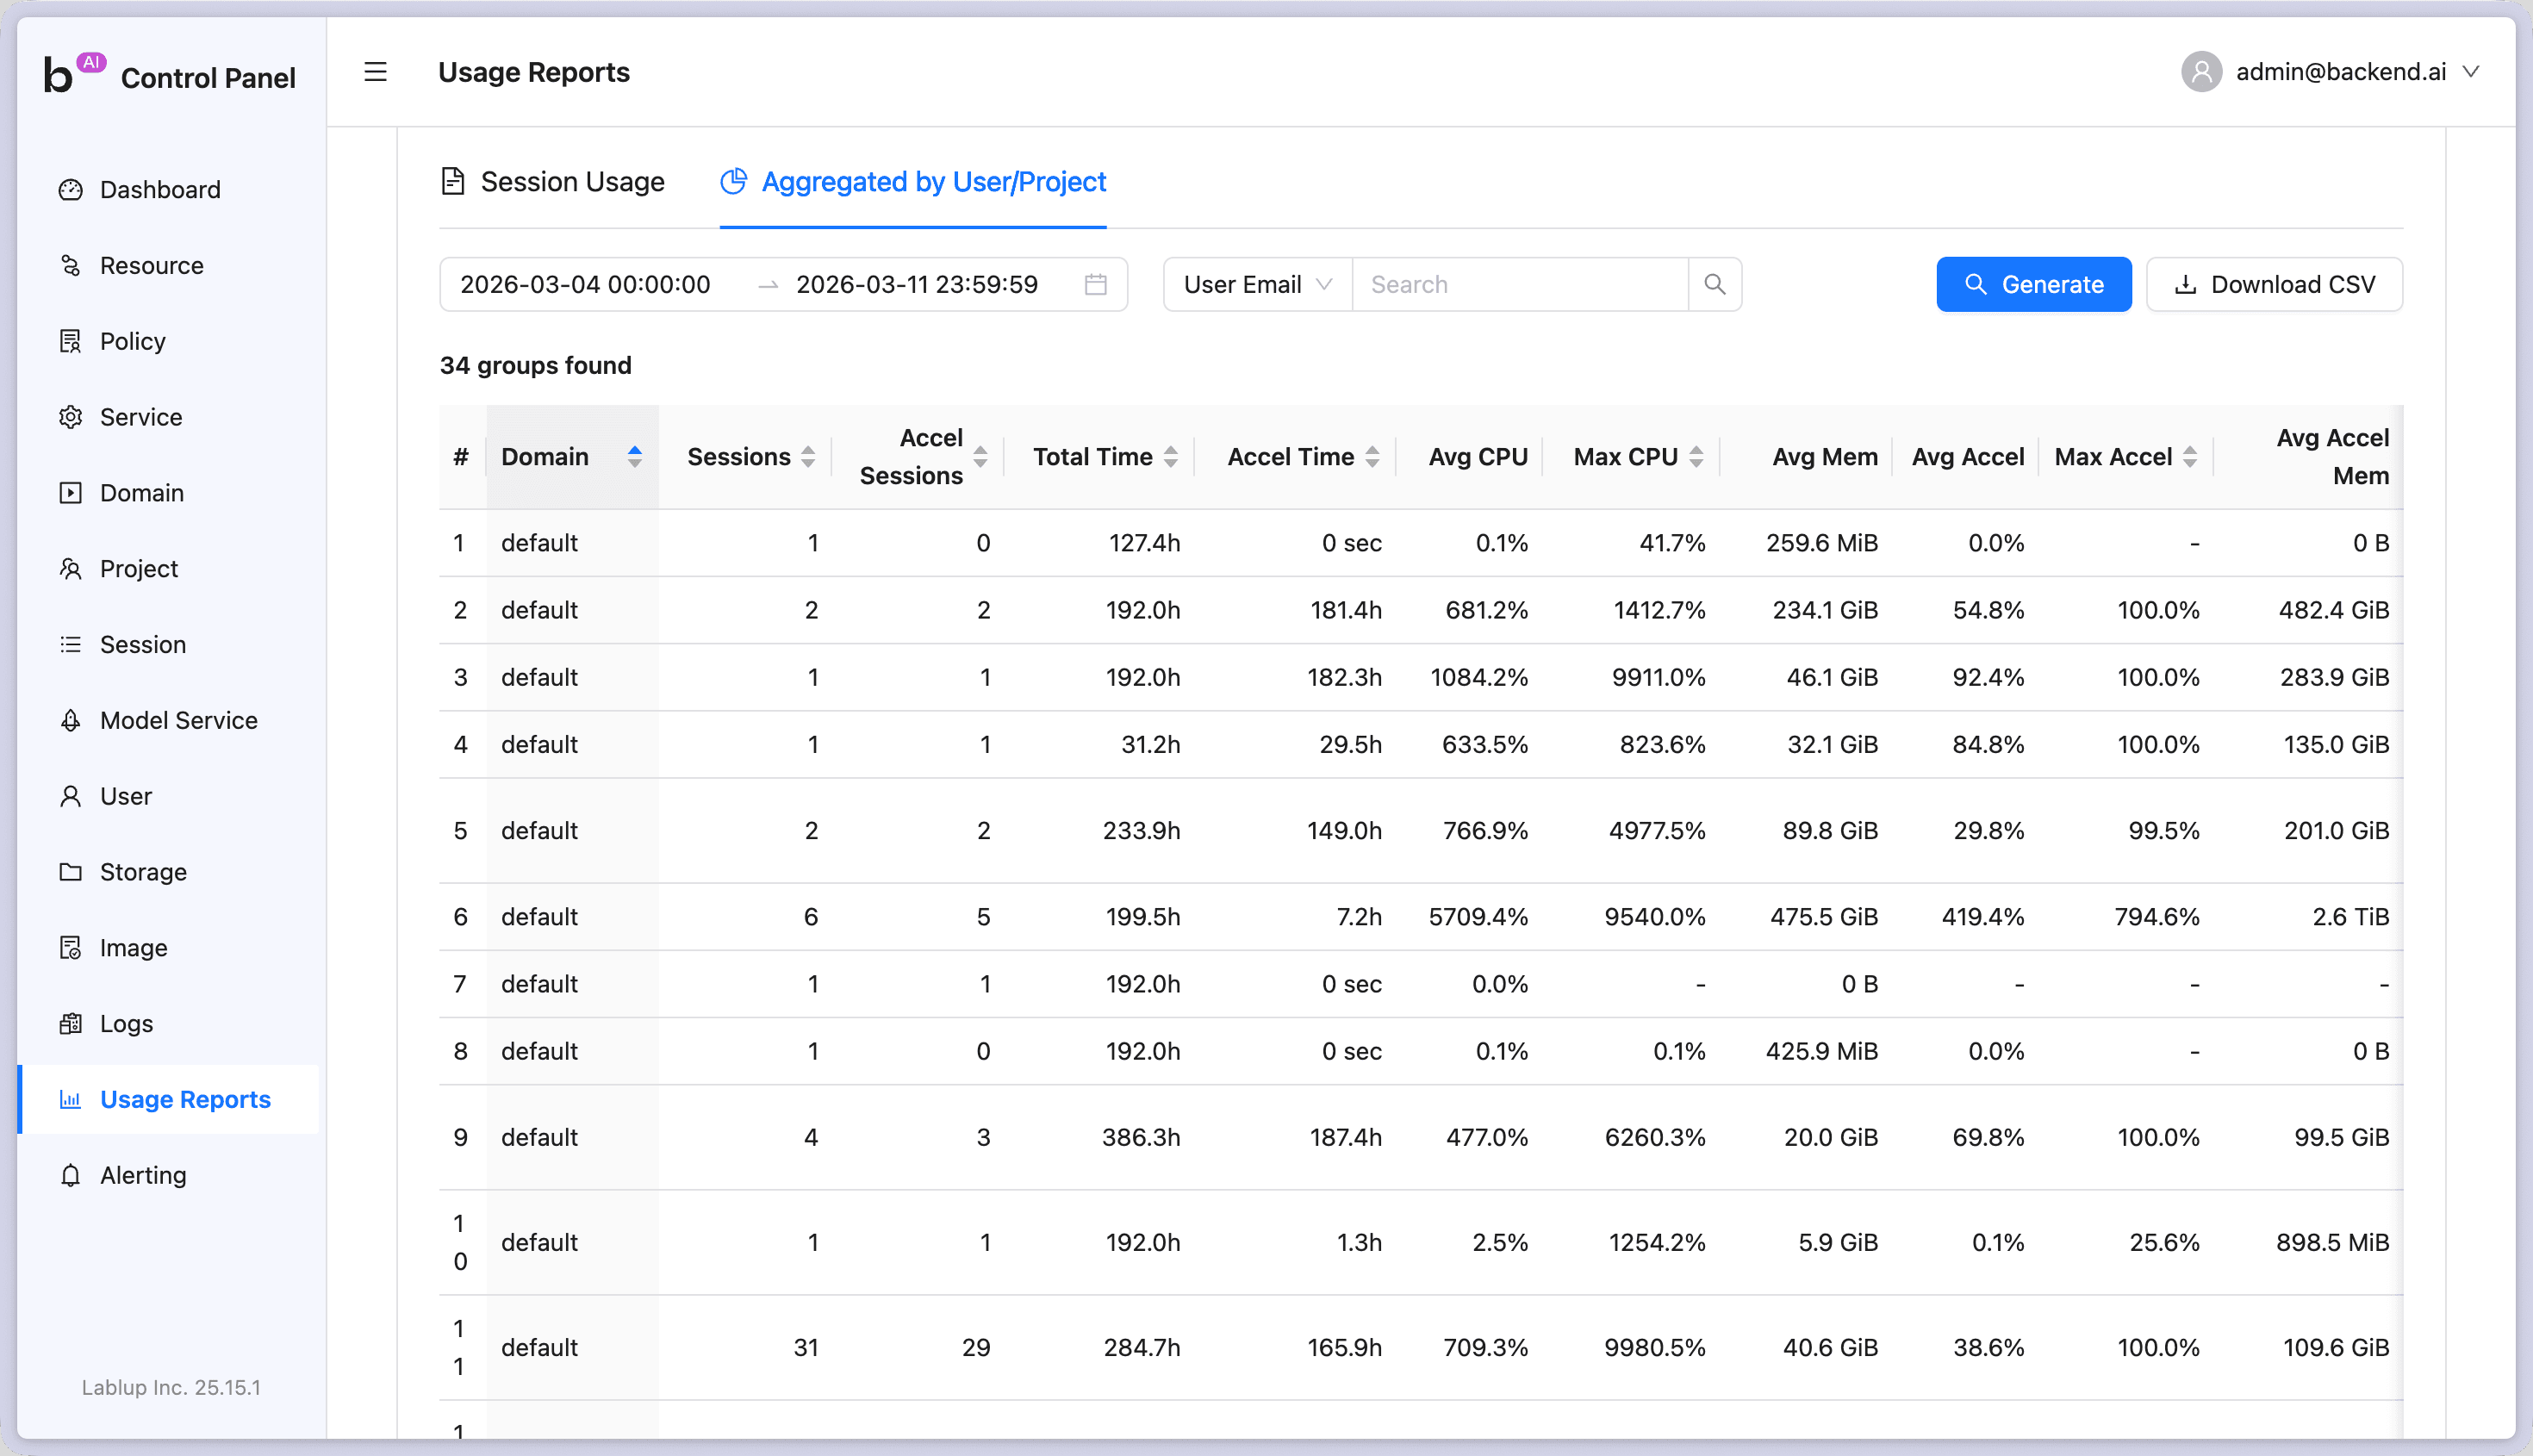
▲ Backend.AI 사용량 보고서. 세션 수와 가속기 사용 시간, 평균 사용률을 사용자나 프로젝트 단위로 집계하며 CSV 내보내기를 지원합니다.
지원 환경과 도입 문의
Slurm Frontend는 Backend.AI 26.8.1 이상을 운영하는 클러스터에서 사용할 수 있습니다. 기존 표준 Slurm 클라이언트와 함께 동작하며, 권장 Slurm 버전은 24.11입니다. 파티션별 우선순위 단계와 선점을 포함해, 이 글에서 소개한 Slurm Frontend 기능은 모두 Backend.AI 26.8.1부터 제공됩니다. Slurm Frontend는 연구자의 작업 스크립트와 익숙한 명령을 유지하므로, 기존 파이프라인을 모두 새 플랫폼에 맞게 수정한 뒤에야 전환할 수 있었던 부담을 줄일 수 있습니다.
Backend.AI에서 Slurm 환경을 사용하려면 래블업 파트너사나 래블업(contact@lablup.com)으로 문의해 주세요. 관련 자료는 다음과 같습니다.
더 알아보기
• Slurm overview, SchedMD
