2026년 11월 6일
출시
MLxcel 0.8 "Eyes Wide Open" - AMD Strix Halo에 눈을 뜨다

래블업 주식회사
래블업 주식회사

신정규
창업멤버 / 연구원 / CEO
2026년 11월 6일
출시
MLxcel 0.8 "Eyes Wide Open" - AMD Strix Halo에 눈을 뜨다
래블업 주식회사
래블업 주식회사
신정규
창업멤버 / 연구원 / CEO
래블업이 개발하는 LLM/VLM 추론 엔진 MLxcel의 0.8 버전이 출시되었습니다. 0.7.0 이후 590개의 커밋이 들어간 이번 릴리즈에서 가장 큰 변화는 지원 하드웨어가 넓어졌다는 점입니다. Apple Silicon과 NVIDIA CUDA에 이어 AMD GPU를 위한 ROCm 백엔드가 추가되었고, Windows 11에서도 CUDA와 ROCm으로 네이티브 추론을 할 수 있게 되었습니다.
그 밖에도 0.8에는 많은 변화가 담겼습니다. 0.8 버전부터는 대부분의 모델 계열이 --parallel 옵션에서 네이티브 배치 디코드로 동작하고, --webui 옵션 하나로 모델 라이브러리와 채팅 화면을 띄우는 번들 WebUI가 포함되었습니다. 또한 FLUX.2 Klein, Qwen-Image-2.1을 비롯한 9종의 이미지 생성 모델과 SAM 3, DINOv2 같은 비전 모델이 추가되었고, 분산 추론에 쓰이는 클러스터 통신에는 연결별 인증과 암호화가 적용되었습니다.
이 글에서는 그중 MLxcel의 AMD Strix Halo 지원을 다룹니다. 11월 4일 열린 AMD Advancing AI World Tour & AI DevDay Seoul 2026에서 발표한 세션 내용을 바탕으로, Strix Halo가 어떤 칩인지, 통합 메모리 구조가 왜 지금 중요한지, 그리고 ROCm 백엔드를 포팅하면서 겪은 문제와 그 결과를 정리합니다.
TL;DR
Strix Halo에서 MLxcel을 쓰려면 ROCm이 설치된 Linux에서 rocm 기능을 켜고 소스에서 빌드하세요. v0.8.1 기준으로 ROCm용 사전 빌드 바이너리는 아직 제공하지 않습니다.
git clone https://github.com/lablup/mlxcel.git
cd mlxcel
cargo build --release --features rocm

# 대화형 실행 (첫 실행 시 모델을 자동으로 내려받습니다)
./target/release/mlxcel run mlx-community/Qwen3-30B-A3B-4bit

# OpenAI 호환 서버 + WebUI, 동시 요청 4개
./target/release/mlxcel-server -m mlx-community/Qwen3-30B-A3B-4bit --port 8080 --parallel 4 --webui
Ryzen AI MAX+ 395(Radeon 8060S, gfx1151)에서 측정한 결과를 요약하면 다음과 같습니다.
- Dense, MoE, VLM 모델과 4비트, FP8, MXFP4 형식을 포함해 테스트한 44개 모델이 모두 동작했습니다.
- 활성 파라미터가 3B인 Nemotron 3 Nano 30B-A3B는 75.9 tok/s로 디코드됩니다.
- Dense 31B 모델인 Gemma 4 31B는 10.2 tok/s로, 메모리 대역폭으로 계산한 이론 상한(약 10.8 tok/s)에 근접합니다. 같은 모델의 prefill은 315 tok/s로 llama.cpp Vulkan(260 tok/s)보다 빠릅니다.
- ROCm 백엔드는 아직 실험적(experimental) 단계이며, 현재 Strix Halo의 GPU인 gfx1151에서만 검증되었습니다.
Strix Halo는 무엇인가
Strix Halo는 AMD가 2025년 초에 공개한 Ryzen AI Max 300 시리즈의 개발 코드명입니다. Strix는 라틴어로 올빼미를 뜻하며 올빼미속(屬)의 학명이기도 합니다. AMD는 Zen 5 기반 모바일 칩 제품군에 이 이름을 붙였고, 일반 노트북용 칩은 Strix Point라고 부릅니다. Halo는 업계에서 브랜드를 대표하는 최상위 제품을 가리키는 말입니다. 즉 Strix Halo는 Strix 제품군의 플래그십입니다. 이번 0.8 릴리즈의 이름인 Eyes Wide Open도 여기서 따왔습니다. 눈이 큰 올빼미처럼, MLxcel이 지원하는 하드웨어를 Apple Silicon 밖으로 넓힌다는 의미입니다.
Strix Halo가 기존 노트북 칩과 다른 점은 큰 GPU와 넓은 메모리 버스를 하나의 패키지에 넣었다는 것입니다. 최상위 모델인 Ryzen AI Max+ 395의 주요 사양은 다음과 같습니다.
| 구성 요소 | 사양 |
|---|---|
| CPU | Zen 5 16코어 32스레드, 최대 5.1GHz |
| GPU | Radeon 8060S, RDNA 3.5 40 CU, 최대 2.9GHz (gfx1151) |
| NPU | XDNA 2, 최대 50 TOPS (플랫폼 전체 126 TOPS) |
| 메모리 | 256비트 LPDDR5X-8000, 최대 128GB, 이론 대역폭 256 GB/s |
| GPU 할당 가능 메모리 | 최대 96GB |
| 전력 | 45~120W (cTDP) |
* AMD 제품 페이지, Tom's Hardware 기준
Strix Halo에는 GPU와 별도로 NPU도 들어 있는데, Microsoft가 정의한 Copilot+ PC 규격을 맞추기 위해서입니다. Copilot+ PC로 인증받으려면 40 TOPS 이상의 NPU와 16GB 이상의 메모리, 256GB 이상의 저장장치를 갖춰야 하고, 이 조건을 만족해야 Windows의 온디바이스 AI 기능을 쓸 수 있습니다. Strix Halo의 50 TOPS NPU는 이 기준을 넘습니다.
다만 40~50 TOPS급 NPU는 늘 켜져 있는 가벼운 AI 기능을 저전력으로 돌리는 용도이고, 수십억 파라미터 규모의 LLM을 돌리기에는 부족합니다. 그래서 NPU는 Windows의 AI 기능을 맡고, 큰 모델 추론은 40 CU GPU와 대용량 통합 메모리가 맡습니다. MLxcel이 사용하는 것은 이 GPU입니다.
다른 회사도 비슷한 구성을 택하고 있습니다. NVIDIA는 2026년 Computex에서 그동안 N1X로 불리던 Windows PC용 칩을 RTX Spark라는 이름으로 공개했습니다. 20코어 Arm Grace CPU와 Blackwell RTX GPU를 한 패키지에 담았고, Dell, HP, ASUS, Lenovo, MSI 등이 올가을부터 탑재 제품을 내놓습니다(Tom's Hardware, The Federal). 젠슨 황은 DGX Spark에 쓰인 GB10이 N1 계열의 한 버전이라고 밝힌 바 있습니다(Winaero). CPU 아키텍처가 x86과 Arm으로 다를 뿐, "큰 GPU + 넓은 통합 메모리 + NPU"라는 구성은 같습니다. AI PC 시장이 통합 메모리 구조 쪽으로 옮겨가고 있습니다.
통합 메모리 구조는 무엇인가
통합 메모리 구조(Unified Memory Architecture, UMA)는 CPU와 GPU가 같은 물리 메모리를 함께 쓰는 구조입니다. 일반적인 PC에서는 CPU가 시스템 메모리(DRAM)를, 외장 GPU가 자기 전용 메모리(VRAM)를 따로 갖고, 둘 사이의 데이터는 PCIe 버스를 거쳐 복사됩니다. 통합 메모리에서는 이 복사가 필요 없습니다. CPU와 GPU가 같은 주소의 텐서를 그대로 읽고 쓰기 때문입니다.
짧은 역사
통합 메모리 자체는 새로운 아이디어가 아닙니다. 여러 회사가 10년 넘게 각자의 방식으로 발전시켜 온 구조이고, 로컬에서 AI 모델을 돌리려는 수요가 늘면서 다시 주목받고 있습니다.
| 연도 | 플랫폼 | 의미 |
|---|---|---|
| 2013~2014 | AMD Kaveri APU, hUMA | CPU와 GPU가 같은 가상 주소 공간을 공유하고, 데이터를 복사하지 않고 서로의 메모리를 읽는 HSA 구조를 처음 하드웨어로 구현 |
| 2014~ | NVIDIA Jetson 계열 | 임베디드 SoC에서 CPU와 GPU가 하나의 LPDDR 메모리를 공유 |
| 2020 | Apple M1 | CPU, GPU, Neural Engine이 패키지 위의 단일 메모리 풀을 공유하는 구조를 데스크톱과 노트북에 대중화 |
| 2023 | NVIDIA GH200 | Grace CPU의 LPDDR5X(최대 480GB)와 Hopper GPU의 HBM3(96GB)를 900 GB/s NVLink-C2C로 묶어 하나의 일관된 주소 공간으로 제공 |
| 2025 | NVIDIA GB10 (DGX Spark) | CPU 다이와 GPU 다이가 128GB LPDDR5X를 하나의 물리적, 논리적 메모리로 공유 |
| 2025 | AMD Strix Halo | x86 노트북과 미니 PC에서 GPU가 최대 96GB를 쓰는 통합 메모리 APU |
Electronic Design, Apple 발표, Chips and Cheese, ServeTheHome 참고
2013년 AMD가 hUMA를 발표할 때의 목표는 GPU가 데이터를 기다리는 시간을 줄이는 것이었습니다. 당시 이 구조의 주된 수혜자는 그래픽과 일반 GPGPU 연산이었습니다. 10여 년이 지난 지금 같은 구조가 다시 주목받는 이유는 LLM입니다.
AI 시대에 통합 메모리가 중요한 이유
LLM 추론, 특히 토큰을 하나씩 생성하는 디코드 단계는 연산 성능보다 메모리 대역폭의 영향을 크게 받습니다. 토큰 하나를 만들 때마다 모델 가중치를 메모리에서 한 번씩 읽어야 하기 때문입니다. 통합 메모리의 이점은 두 가지입니다.
첫째는 용량입니다. 소비자용 외장 GPU의 VRAM은 보통 24~32GB 수준이라 30B급 모델을 4비트로 양자화해도 여유가 많지 않습니다. GPU가 96GB를 쓸 수 있는 Strix Halo에서는 30B급 모델은 물론, 더 큰 모델도 통째로 메모리에 올릴 수 있습니다.
둘째는 MoE(Mixture-of-Experts) 모델에 유리하다는 점입니다. 최근 오픈 모델의 상당수는 전체 파라미터는 크지만 토큰마다 일부 전문가(expert)만 활성화되는 MoE 구조입니다. 외장 GPU에서 모델 전체가 VRAM에 들어가지 않으면, 넘치는 전문가 가중치를 PCIe 버스로 옮겨와야 합니다. 그런데 어떤 전문가가 선택될지는 데이터에 따라 달라지므로, 토큰마다 전문가 가중치 전송을 기다리느라 연산이 멈출 수 있습니다. 호스트 쪽에 가중치를 한 번 더 올려 두는 스테이징 복사 때문에 메모리 사용량과 대역폭 소모가 두 배가 되기도 합니다. 통합 메모리에서는 희소(sparse) 체크포인트 전체가 메모리에 올라가 있고, 각 토큰은 활성화된 전문가의 가중치만 읽습니다. 이때 디코드 속도는 메모리 대역폭에 따라서만 달라집니다.
단점도 있습니다. Strix Halo의 이론 대역폭 256 GB/s는 데이터센터 GPU의 HBM(GH200의 HBM3는 4 TB/s)보다 한 자릿수 이상 낮습니다. 그래서 통합 메모리 장비에서는 전체 크기가 같아도 활성 파라미터가 작은 MoE 모델이 dense 모델보다 훨씬 빠릅니다. 이 차이는 뒤의 벤치마크에서 수치로 확인하겠습니다.
회사마다 다른 통합 메모리
같은 통합 메모리라도 메모리 컨트롤러가 어느 다이에 있는지는 회사마다 다릅니다. GB10은 CPU 다이에, Strix Halo는 GPU가 있는 I/O 다이에, Apple Silicon은 CPU와 GPU가 함께 있는 SoC 다이에 메모리 컨트롤러가 있습니다.
| 플랫폼 | 메모리 컨트롤러 위치 | CPU와 GPU의 연결 | 메모리 풀 | 대역폭 |
|---|---|---|---|---|
| Apple Silicon | CPU, GPU, Neural Engine과 같은 SoC 다이 | 같은 다이 안에서 직접 연결 | 하나의 일관된(coherent) 풀 | M1 68 GB/s, 상위 칩일수록 증가 |
| NVIDIA GB10 | MediaTek이 설계한 CPU 다이(S-die) | NVLink C2C, 양방향 600 GB/s | 128GB 단일 풀 | 301 GB/s (LPDDR5X-9400) |
| AMD Strix Halo | GPU, NPU와 같은 대형 I/O 다이(IOD) | Zen 5 CCD 두 개가 IOD에 다이 간 링크로 연결 | 부팅 시 나뉘는 두 풀 (테스트 장비 기준 GPU 96GiB, OS 약 31GiB) | 256 GB/s (LPDDR5X-8000) |
GB10은 메모리 컨트롤러가 CPU 다이에 있어서, GPU는 C2C 링크를 거쳐 메모리에 접근합니다. NVIDIA는 GPU 메모리 트래픽이 MediaTek의 메모리 서브시스템을 거쳐도 충분한 대역폭이 나오도록 MediaTek과 함께 성능 모델링을 했다고 밝혔습니다. Strix Halo는 반대입니다. GPU와 메모리 컨트롤러, 32MB 크기의 MALL 캐시가 같은 IOD에 있고, CPU 칩렛이 그 옆에 붙는 구조입니다. 즉 메모리가 GPU에 가장 가까이 있습니다. 대신 CPU 코어는 GPU의 마지막 단계 캐시를 쓸 수 없습니다.
추론 엔진에 가장 큰 영향을 주는 차이는 메모리 풀을 나누는 방식입니다. Apple Silicon과 GB10은 하나의 풀을 운영체제와 GPU가 함께 씁니다. Strix Halo는 펌웨어 설정으로 GPU 몫(carve-out)을 미리 떼어 두기 때문에, 운영체제가 보는 메모리와 GPU가 쓸 수 있는 메모리가 다릅니다. 이 차이 때문에 포팅 중에 생긴 문제는 다음 절에서 다룹니다.
Linux에서는 GTT로 더 유연하게
Linux에서는 BIOS carve-out 대신 GTT(Graphics Translation Table)로 GPU 메모리를 동적으로 잡는 방법도 있습니다. AMD 문서에 따르면 Strix Halo의 GPU는 GPU 가상 메모리(GPUVM)를 통해 시스템 메모리에 접근하므로, 메모리는 물리적으로 나뉘는 것이 아니라 매핑될 뿐입니다. GTT 할당은 영구적으로 예약되지 않아서, GPU가 쓰지 않는 동안에는 운영체제가 그 메모리를 회수할 수 있습니다.
기본 GTT 한도는 시스템 메모리의 약 50%라서, 128GB 장비에서는 60GB 남짓입니다. AMD는 BIOS의 전용 VRAM은 0.5GB 정도로 작게 두고, 커널의 TTM 페이지 한도(/sys/module/ttm/parameters/pages_limit)를 올리는 방식을 권장합니다. 예전에 쓰던 amdgpu.gttsize 파라미터는 TTM 설정으로 대체되는 추세입니다. GTT 한도가 VRAM보다 크면 드라이버는 VRAM 할당 요청도 GTT로 처리합니다.
# AMD 디버그 도구로 현재 한도를 확인하고 변경 (재부팅 필요)
pipx install amd-debug-tools
amd-ttm              # 현재 TTM 한도 확인
amd-ttm --set 100    # GPU가 쓸 수 있는 공유 메모리를 100GB로

# 또는 커널 파라미터로 직접 지정 (4KiB 페이지 단위, 아래는 120GiB)
ttm.pages_limit=31457280
두 방식의 차이는 다음과 같습니다.
| 항목 | BIOS carve-out | GTT |
|---|---|---|
| 메모리 확보 방식 | 부팅 시 고정 예약, GPU가 쓰지 않아도 운영체제는 못 씀 | 필요할 때 할당, GPU가 쓰지 않으면 운영체제가 회수 |
| GPU가 쓸 수 있는 최대 크기 | 최대 96GB | 커널 한도까지 128GB 장비에서 120GB 안팎으로 설정한 사례 다수 |
| 설정 변경 | BIOS 진입 | 커널 파라미터 또는 amd-ttm, 재부팅 필요 |
| 엔진이 보는 GPU 메모리 | 장치 메모리로 그대로 보고 | 작은 VRAM 영역만 보일 수 있어 GTT 크기를 따로 읽어야 함 |
| 운영체제와의 경합 | 경계가 고정되어 서로 침범하지 않음 | 같은 풀을 나눠 쓰므로 한도를 너무 높이면 운영체제 메모리가 부족해짐 |
| 지원 범위 | 운영체제와 무관 | Linux 전용, Strix Halo용 KFD 수정이 들어간 커널 필요 |
GTT의 가장 큰 장점은 메모리를 놀리지 않는다는 점입니다. 96GB를 고정으로 떼어 두면 모델을 올리지 않은 시간에도 그 메모리는 운영체제가 쓸 수 없습니다. GTT에서는 필요할 때만 GPU가 가져가고, 한도도 96GB보다 높게 잡을 수 있어 100GB에 가까운 큰 MoE 모델까지 노려볼 수 있습니다. 대신 주의할 점도 있습니다.
- 메모리 크기를 읽는 방법이 엔진마다 다릅니다. GTT 구성에서는 HIP이 보고하는 VRAM이 작게 나오는 경우가 있어, vLLM의 Strix Halo 포크는 sysfs의 GTT 크기를 직접 읽도록 고쳤고(randomvariable/vllm), llama.cpp에서도 TTM 할당을 쓰는 Strix Halo에서 메모리 감지 로직을 조정하자는 제안이 나왔습니다(llama.cpp #18159). 엔진이 메모리 예산을 어떤 값으로 잡는지가 carve-out보다 훨씬 중요해집니다.
- 운영체제의 몫을 남겨야 합니다. 운영체제와 GPU가 같은 풀을 나눠 쓰므로, 한도를 전체 메모리에 너무 가깝게 잡으면 큰 모델을 올리는 순간 운영체제가 메모리 부족에 빠질 수 있습니다. 커뮤니티에서는 보통 운영체제용으로 몇 GB를 남겨 둡니다.
- 성능 차이는 직접 재 봐야 합니다. 미리 할당한 VRAM과 GTT 사이에 차이가 없었다는 보고와 VRAM 쪽이 더 빨랐다는 보고가 함께 있습니다. IOMMU를 끄면 메모리 대역폭이 5~10% 오른다는 보고도 있지만, 아직 검증된 결과는 아닙니다(Framework 커뮤니티).
이 글의 측정은 함께 개발한 네이티브 Windows ROCm과 비교하기 위해, 모두 BIOS에서 96GiB를 떼어 둔 carve-out 구성에서 진행했습니다.
Strix Halo를 위한 ROCm 포팅
테스트 환경
이 글의 모든 측정은 Ryzen AI MAX+ 395(Radeon 8060S, gfx1151) 장비에서 Debian 13, ROCm 10.0(HIP 7.15)으로 진행했습니다. 펌웨어에서 GPU 몫으로 96GiB를 떼어 두었고, 운영체제는 나머지 약 31GiB를 사용하는 구성입니다.
RDNA 3.5와 wave32
Radeon 8060S는 RDNA 3.5 아키텍처의 GPU입니다. 포팅할 때 가장 도움이 된 특징은 wave32입니다. AMD GPU는 명령을 실행하는 스레드 묶음을 웨이브프론트(wavefront)라고 부르는데, RDNA는 기본적으로 32개 스레드를 한 묶음으로 실행합니다. CUDA의 warp, Metal의 simdgroup과 같은 폭입니다. 덕분에 warp 단위의 리덕션이나 셔플을 전제로 작성한 커널 로직을 큰 수정 없이 옮길 수 있었습니다.
다른 점도 있습니다. 행렬 연산은 WMMA(Wave Matrix Multiply-Accumulate) 명령으로 처리하며 16x16x16 크기의 bf16, f16 연산을 지원합니다. hipBLASLt로 기능을 확인한 결과 bf16과 int8은 지원하고 fp8은 지원하지 않았으며, FP4 행렬 명령은 아예 없습니다. 세 플랫폼을 비교하면 다음과 같습니다.
| 항목 | ROCm (RDNA 3.5, gfx1151) | Metal (Apple Silicon) | CUDA (NVIDIA) |
|---|---|---|---|
| SIMD 폭 | wave32 (CDNA는 wave64) | simdgroup 32 | warp 32 |
| 행렬 연산 | WMMA 16x16x16, bf16/f16 | simdgroup matrix | Tensor Core |
| FP8 / FP4 연산 | 없음, 소프트웨어로 디코드 | 없음, 소프트웨어로 디코드 | Hopper 이후 FP8, Blackwell FP4 |
| 메모리 | 통합 메모리, 두 풀로 분리 | 통합 메모리, 단일 풀 | PCIe 너머의 외장 VRAM |
| 커널 빌드 | 대부분 AOT, 일부 hipRTC JIT | 런타임 생성 후 캐시 | NVRTC JIT 후 캐시 |
| GPU 폴트 이후 | 프로세스 종료까지 모든 HIP 호출 실패 | MLX 이벤트로 오류 보고 | 리셋 전까지 sticky error |
Metal과 CUDA 열은 플랫폼의 일반적인 특성이며, Strix Halo 장비에서 측정한 값은 아닙니다.
수치 특성도 하나 알아 둘 필요가 있습니다. gfx11 계열의 WMMA는 bf16과 f16에서 1 + (−1)을 계산하면 0이 아니라 −2⁻²⁴를 반환합니다. 이 오차는 표준적인 f32 내적의 오차 범위 안에 있지만, 결과를 비트 단위로 비교하는 테스트를 작성할 때는 고려해야 합니다.
RDNA와 CDNA는 무엇이 다른가
AMD GPU에는 두 갈래의 아키텍처가 있습니다. Radeon과 APU에 쓰이는 RDNA, 그리고 Instinct 데이터센터 가속기에 쓰이는 CDNA입니다. 둘 다 ROCm과 HIP으로 프로그래밍하지만 하드웨어 구조는 꽤 다릅니다.
| 항목 | RDNA (Radeon, Strix Halo) | CDNA (Instinct MI300X, MI355X 등) |
|---|---|---|
| 기본 웨이브 폭 | wave32 (wave64 모드 선택 가능) | wave64 |
| 행렬 연산 | WMMA 명령 (RDNA 3부터) | 전용 Matrix Core와 MFMA 명령 |
| 저정밀도 형식 | gfx1151 기준 FP8, FP4 행렬 명령 없음 | 세대에 따라 FP8, FP4까지 하드웨어 지원 |
| 메모리 | LPDDR, GDDR | HBM |
같은 HIP 소스가 양쪽에서 컴파일되더라도, wave32와 WMMA에 맞춰 튜닝한 커널이 wave64와 MFMA에서 같은 성능을 내지는 않습니다. MLxcel의 ROCm 백엔드는 현재 gfx1151에서만 검증되었으므로, 다른 하드웨어에서는 결과가 다를 수 있습니다.
AMD는 올해 여름 Advancing AI 2026 본행사에서 공개한 CDNA 5(MI455)를 RDNA 기반으로 다시 설계했으며, wave64 지원을 사실상 접고 wave32로 실행한다고 밝혔습니다(Chips and Cheese). 두 아키텍처가 다시 가까워지는 만큼, Strix Halo용으로 작성한 wave32 커널은 앞으로 CDNA를 지원할 때 출발점으로 쓸 수 있습니다.
mlxcelverse: 지원 범위를 넓히는 방법
MLxcel의 구조부터 간단히 보겠습니다. CLI와 OpenAI 호환 서버가 진입점이고, 모델 로딩과 자동 감지, 토크나이저, 멀티모달 파이프라인, 배치 스케줄러로 이루어진 제어 영역(control plane)은 Rust로 작성되어 있습니다. 생성 루프와 KV 캐시, 샘플링, speculative decoding을 담당하는 데이터 영역(data plane)은 C++ 코어이고, FFI 브리지를 거쳐 하드웨어 실행 계층을 호출합니다. Apple Silicon에서는 MLX의 Metal 런타임이, 그 밖의 하드웨어에서는 mlxcelverse가 이 실행 계층을 맡습니다.
mlxcelverse는 MLX 위에 덮어쓰는 오버레이와 mlxcel 전용 커스텀 커널을 모아 둔 프로젝트입니다. CUDA, ROCm, OpenXLA 백엔드가 모두 이곳에 있고, 각 오버레이는 자신이 기반으로 하는 MLX 커밋을 명시합니다. 이번 ROCm 백엔드의 출발점은 커뮤니티의 MLX ROCm 포크인 NripeshN/mlx(MIT 라이선스)였습니다. 2025년 6월 업스트림 MLX에 실험적 ROCm 백엔드로 제안된 작업이며(ml-explore/mlx #2300), 106개의 새 백엔드 파일과 약 4만 3,900줄의 코드로 이루어져 있습니다.
저희는 이 포크를 패치로 적용하는 대신 파일 단위 오버레이로 가져왔습니다. mlxcelverse의 ROCm 오버레이는 111개의 백엔드 파일과 16개의 MLX 코어 파일로 구성되며, 빌드할 때 MLxcel이 고정해 둔 MLX 커밋(pin) 위에 파일을 통째로 복사합니다. Metal과 CUDA 빌드가 쓰는 것과 같은 pin이고, ROCm 파일은 ROCm 빌드에서만 적용됩니다.
- pin을 올려도 패치 충돌이 생기지 않습니다. 파일을 통째로 교체하므로 patch fuzz나 같은 hunk가 두 번 적용되는 문제가 없습니다.
- pin을 올릴 때마다 드리프트를 검사합니다. make verify에 포함된 오프라인 검사로 2초 만에 끝나며, Mac에서 MLX pin을 올리고 ROCm 오버레이를 갱신하지 않으면 바로 실패합니다.
포팅 과정
| 날짜 (2026년) | 진행 상황 |
|---|---|
| 9월 11일 | 스파이크: 포크 단독 빌드 성공, 42개 연산 테스트 모두 통과 |
| 9월 12일 | 오버레이를 mlxcel에 병합 |
| 9월 30일 | gfx1151에서 첫 처리량 기준선 측정 |
| 10월 15일 | ROCm 에픽 종료, 테스트 12,384개 통과 |
| 10월 21일 | v0.8.0-beta.1 릴리즈 |
| 10월 26일 | Windows 네이티브 빌드, 네이티브 NVFP4 커널 |
| 11월 1~2일 | v0.8.0, v0.8.1 릴리즈 |
스파이크부터 ROCm 에픽을 닫기까지 약 5주가 걸렸습니다. 이 기간 동안 저희는 포크에서 70건의 결함을 고쳤습니다. 대부분은 커뮤니티 포크에서도 존재하는 결함들이었습니다.
| 분류 | 문제 | 수정 |
|---|---|---|
| 그리드 한계 | 32비트 그리드 계산 때문에 2³²개 이상의 스레드로 커널을 띄우지 못했고, 한 커널은 마지막 257개 원소를 쓰지 않음 | 64비트 grid-stride 루프로 변경 |
| 스레드 안전성 | BLAS 핸들, JIT 캐시, 이벤트 풀에 잠금이 없어 8스레드 테스트가 20번 중 20번 실패 | 잠금 추가 후 20번 중 0번 실패 |
| 양자화 커널 | 잘못된 scale stride와 dtype 분기로 MXFP4, MXFP8에서 NaN 또는 최대 1e34의 상대 오차 | stride와 분기 수정 |
| 누락된 연산 | FFT, Hadamard, SearchSorted가 std::terminate를 부르는 빈 껍데기 | 네이티브 HIP 커널로 구현 |
| GPU 폴트 처리 | 큐 폴트 이후 모든 HIP 호출이 실패하는데, 대기 함수는 영원히 블록 | 대기 함수가 오류를 반환하도록 변경 |
| 빌드 시스템 | 헤더를 고쳐도 HIP 오브젝트가 다시 빌드되지 않음 (41개 중 0개) | 의존성 파일로 헤더 변경 추적 |
결함 수정과 함께 검증 체계도 갖췄습니다. 자체 호스팅 gfx1151 러너가 CI에서 ROCm 빌드와 링크, 실제 생성까지 확인하고, 같은 검증을 로컬에서 make verify-rocm으로 실행할 수 있습니다.
통합 메모리에서 만난 문제들
앞 절에서 Strix Halo의 메모리 풀이 둘로 나뉜다고 했는데, 실제로 이 구조가 가장 많은 시행착오를 만들었습니다.
-
**예산은 장치 메모리 기준으로 잡아야 합니다. **MLxcel은 모델을 올리기 전에 메모리에 들어갈지 미리 계산합니다. 이 계산을 운영체제의 여유 메모리 기준으로 하면 약 31GiB밖에 보이지 않아, 26GB 크기의 Mixtral조차 건너뛰게 됩니다. 지금은 96GiB 장치 풀을 기준으로 예산을 잡습니다. 반대로 빌드와 CPU 참조 실행은 약 31GiB의 OS 메모리 안에 들어가야 합니다.
-
메모리 예산은 장치 풀 기준으로 잡아야 합니다. MLxcel은 모델을 올리기 전에 메모리에 들어갈지 미리 계산합니다. 이 계산을 운영체제의 여유 메모리 기준으로 하면 약 31GiB만 잡혀서, 26GB 크기의 Mixtral도 건너뛰게 됩니다. 지금은 96GiB 장치 풀을 기준으로 예산을 잡습니다. 반면 빌드와 CPU 참조 실행은 약 31GiB의 OS 메모리 안에서 처리해야 합니다.
-
CPU 폴백 중에는 GPU가 대기합니다. 처음에는 NVFP4 역양자화를 CPU에서 처리했는데, 1.5초짜리 prefill 중 약 1초 동안 GPU가 유휴 상태였습니다. CPU가 GPU 몫의 메모리를 캐시 없이 읽기 때문입니다. 지금은 이 작업을 GPU에서 처리합니다.
-
캐시 라인을 공유하면 오류 없이 결과가 틀린다. 멀티스레드 OpenBLAS 환경에서 촘촘하게 배치된 GPU 스칼라 값을 읽을 때 오래된(stale) 캐시 라인이 읽혀, 오류 없이 틀린 결과가 나오는 경우가 있었습니다. BLAS 스레드를 하나로 제한하고 스칼라 슬롯 간격을 128바이트로 넓혀서 해결했습니다.
-
진행 중인 GPU 작업량에 상한을 두어야 합니다. 호스트가 GPU 완료를 기다리지 않고 2,000개 연산마다 작업을 계속 제출하고 있었습니다. 진행 중인 작업량에 상한을 두자 Llama 3.1 8B 4비트의 최대 메모리 사용량이 20.6GB에서 6.1GB로 3.4배 줄었고, 디코드 속도는 변하지 않았습니다.
OpenXLA + IREE 경로와 무엇이 다른가
MLxcel에는 Apple Silicon 이외의 하드웨어를 지원하는 경로가 이미 하나 있었습니다. v0.6.0부터 알파 단계로 제공된 OpenXLA 백엔드입니다. 모델을 StableHLO 그래프로 내보내고 IREE 컴파일러가 대상 하드웨어용 코드를 생성하는 방식으로, TPU와 NPU 같은 가속기를 대상으로 합니다. IREE 자체도 HIP으로 AMD GPU를 지원하므로(IREE 문서), 이론적으로는 이 경로로도 Strix Halo를 지원할 수 있었습니다.
그래도 저희가 네이티브 ROCm 백엔드를 택한 이유는 두 경로의 성격이 다르기 때문입니다.
| 항목 | 네이티브 ROCm (mlxcelverse) | OpenXLA + IREE |
|---|---|---|
| 방식 | MLX 연산 자체를 AMD GPU에서 실행 | 모델 그래프를 컴파일러에 넘겨 코드 생성 |
| 모델 지원 | Metal, CUDA와 같은 모델 코드를 그대로 사용 | 모델 계열마다 그래프 경로를 따로 포팅 |
| 입력 형태 | 동적 길이, continuous batching, paged attention | 미리 컴파일한 컨텍스트 크기 중 가장 작은 것에 요청을 배정 |
| 최적화 수단 | 손으로 쓴 fused HIP 커널 | 컴파일러 최적화 |
| 성숙도 | 실험적, gfx1151에서 검증 | 알파 |
네이티브 경로는 백엔드마다 커널을 직접 작성해야 하는 부담이 있지만, 그 대신 MLxcel이 지원하는 167개 아키텍처와 서빙 기능 전체를 Strix Halo에서 그대로 쓸 수 있습니다. 컴파일 경로는 MLX 백엔드가 없는 가속기를 지원하는 방법으로 계속 발전시킬 계획입니다.
포팅 결과
44개 모델, 모두 동작
포팅의 첫 번째 기준은 호환성이었습니다. mlxcel이 지원하는 167개 아키텍처 중 44개 모델을 골라 v0.8.1, ROCm 10.0 환경에서 prefill 512토큰, 디코드 128토큰(pp512/tg128), batch 1로 모델당 한 번씩 측정했습니다. 결과가 유난히 낮게 나온 8개 모델은 한 번 더 측정했습니다. Dense, MoE, VLM 모델과 4비트, FP8, MXFP4 형식을 모두 포함했고, 44개 모델이 모두 동작했습니다. 아래 수치는 mlx-lm 대비 비율이 아니라 절대 처리량입니다. Python MLX 참조 구현이 ROCm에서 동작하지 않기 때문입니다.
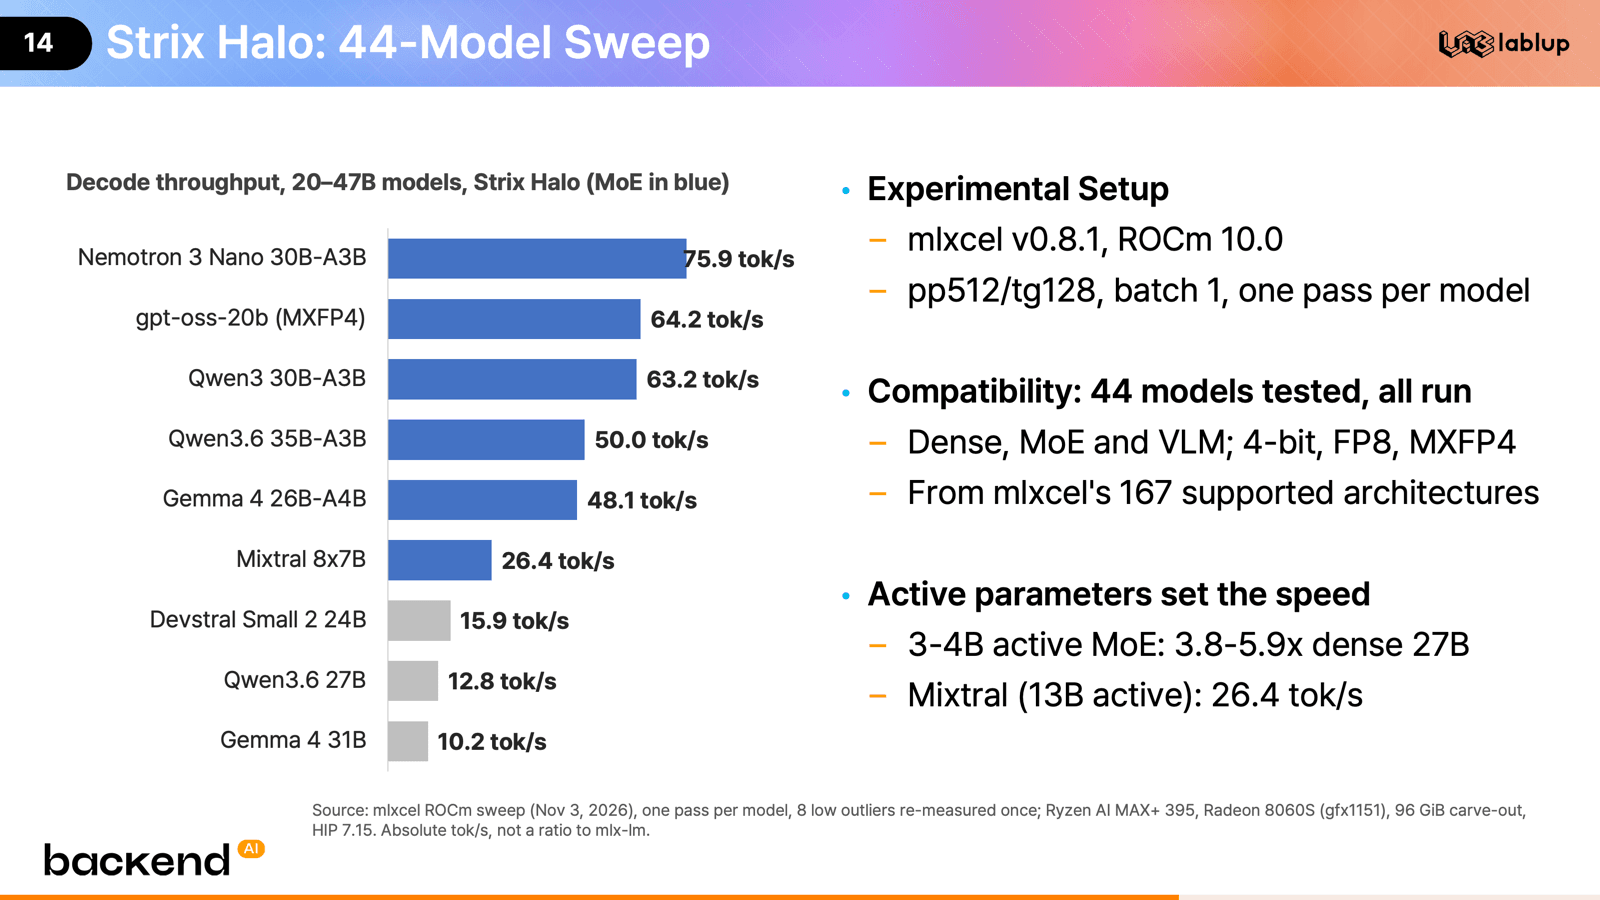
디코드 속도는 전체 파라미터가 아니라 활성 파라미터 수에 따라 달라집니다. 활성 파라미터가 34B인 MoE 모델은 4876 tok/s로 대화형으로 쓰기에 충분하고, dense 27B 모델보다 3.8~5.9배 빠릅니다. 활성 파라미터가 13B인 Mixtral 8x7B는 그 중간인 26.4 tok/s입니다. 앞에서 설명한 통합 메모리의 MoE 이점이 수치로 확인됩니다.
블록 부동소수점 형식을 소프트웨어로 디코드하기
gfx1151에는 FP8과 FP4 행렬 명령이 없습니다. 그래서 MXFP4, MXFP8, NVFP4처럼 블록 단위로 scale을 공유하는 저정밀도 형식의 가중치는 커널 안에서 fp16 또는 bf16으로 변환한 뒤, FMA나 WMMA로 곱합니다. 처음 가져온 구현에서는 이 경로가 가장 느렸고, 그만큼 개선 폭도 가장 컸습니다.
| 항목 | 모델, 조건 | 이전 | 이후 | 개선 |
|---|---|---|---|---|
| MXFP4 prefill | gpt-oss-20b, 512토큰 | 7.5 tok/s | 526 tok/s | 70배 |
| MXFP4 decode | gpt-oss-20b | 8.3 tok/s | 63.6 tok/s | 7.6배 |
| NVFP4 prefill | Nemotron-Cascade-2 30B-A3B, 512토큰 | 329 tok/s | 1,008 tok/s | 3.1배 |
MXFP4 prefill은 전문가 단위로 묶어 처리하는 커널로 바꾸면서 70배 빨라졌습니다. 디코드에서는 기존의 행 단위 커널이 115ms짜리 한 스텝 중 약 100ms를 차지하고 있었습니다. NVFP4 prefill은 역양자화를 GPU로 옮기고 WMMA를 쓰면서 3.1배 빨라졌습니다. 구현 기법 두 가지를 소개합니다.
- 분기 없는 비트 배치. FP4(E2M1)는 부호 1비트, 지수 2비트, 가수 1비트로 이루어진 4비트 값입니다. 각 4비트 값을 조건 분기 없이 fp16의 부호, 지수, 가수 비트 위치에 바로 써 넣고, 마지막에 곱셈 한 번으로 2⁻¹⁴만큼의 지수 오프셋을 보정합니다. 근사가 아니라 정확한 디코드입니다.
- 행 수에 따라 WMMA 사용 여부를 결정. RDNA 3.5에서는 처리할 행이 128개 미만일 때만 fused WMMA 커널이 역양자화 후 hipBLASLt를 부르는 방식보다 빨랐습니다. 그래서 측정한 행 수 기준으로 경로를 고르고, NVFP4 WMMA 타일은 전문가당 16행부터 씁니다.
프로파일링이 정한 포팅 순서
커뮤니티 포크에는 MLX의 기본 연산은 구현되어 있었지만, MLxcel이 Metal과 CUDA에서 쓰는 fused 커널은 없었습니다. 처음에는 호출 횟수가 많은 커널부터 HIP으로 이식하려 했습니다. 그러나 실제 GPU 실행 시간을 측정해 보니 우선순위가 달랐습니다. SSM 업데이트가 가장 앞섰고, fused add-RMSNorm과 RoPE는 상대적으로 뒤로 밀렸습니다.
| 포팅한 커널 | 측정 모델, 조건 | 디코드 속도 향상 |
|---|---|---|
| Paged attention | Llama 3.1 8B 4비트, 컨텍스트 32K | 1.77배 |
| SSM 업데이트 | Granite 4.0-H Tiny | 1.46배 |
| SSM 업데이트 | Nemotron-3-Nano | 1.45배 |
| Paged attention | Llama 3.1 8B 4비트, 컨텍스트 16K | 1.40배 |
| 샘플러 | Llama 3.1 8B | 1.11배 |
| Fused MoE | Qwen3-30B-A3B | 1.02배 |
속도 향상 수치는 각 커널을 포팅하기 전후의 batch 1 디코드 tok/s를 비교한 값입니다. Paged attention은 서버 경로에서 측정했습니다.
프로파일링 결과, dense 모델과 하이브리드 모델은 병목의 성격이 달랐습니다. Llama 3.1 8B 같은 dense 모델은 디코드 시간이 거의 커널 하나에 몰려 있었습니다. qmv_wide 커널이 GPU 시간의 95%를 차지했고, 이때 메모리 읽기 속도는 약 192 GB/s였습니다. Mamba 계열 레이어가 섞인 하이브리드 모델은 커널 실행 횟수 자체가 병목이었습니다. 토큰 하나를 만드는 데 커널을 2,000~3,200번 실행하다 보니 토큰마다 호스트 쪽에서 약 5ms의 공백이 생겼습니다. 그래서 SSM 업데이트 커널부터 포팅했습니다.
메모리 벽: Gemma 4 31B를 엔진별로 비교하면
dense 모델에서 MLxcel이 하드웨어 성능을 어디까지 활용하는지 확인하기 위해, Dense 31B 4비트 모델인 Gemma 4 31B로 다른 엔진과 비교했습니다.
| 엔진 | 백엔드 | Prefill | Decode |
|---|---|---|---|
| mlxcel v0.8.1 | ROCm | 315 tok/s | 10.2 tok/s |
| llama.cpp | ROCm | 공개 수치 없음 | 10.5 tok/s |
| llama.cpp | Vulkan | 260 tok/s | 10.9 tok/s |
| llama.cpp (QAT 모델) | Vulkan | 276 tok/s 5,471토큰 프롬프트, 서버 실행 | 10.3 tok/s |
모든 행은 4비트 가중치 기준이며, 측정한 장비는 서로 다릅니다. llama.cpp 수치는 llama.cpp GitHub Discussion #23659(2026년 5월), EVO-X2의 Gemma 4 31B 벤치마크 보고(2026년 6월), strix-halo-guide(2026년 7월)에서 가져왔습니다.
디코드는 네 경우 모두 10.2~10.9 tok/s로, 차이가 6% 이내입니다. 디코드 속도의 상한이 엔진이 아니라 메모리 대역폭으로 결정되기 때문입니다. EVO-X2 보고에서 실측한 대역폭 212 GB/s를 가중치 크기 19.6GB로 나누면 약 10.8 tok/s가 나옵니다. 토큰 하나를 만들 때마다 가중치 전체를 한 번 읽어야 하므로, 어떤 엔진도 이 값을 넘을 수 없습니다. mlxcel의 디코드 속도는 이 상한에 거의 도달했습니다.
반면 prefill은 연산 성능에 좌우되므로 엔진 간 차이가 드러납니다. prefill에서는 mlxcel이 315 tok/s로 llama.cpp Vulkan의 260 tok/s보다 빠릅니다.
모델별 대역폭 사용률
같은 방법으로 모델별 대역폭 사용률을 추정하면, dense 모델과 MoE 모델의 차이가 더 분명해집니다.
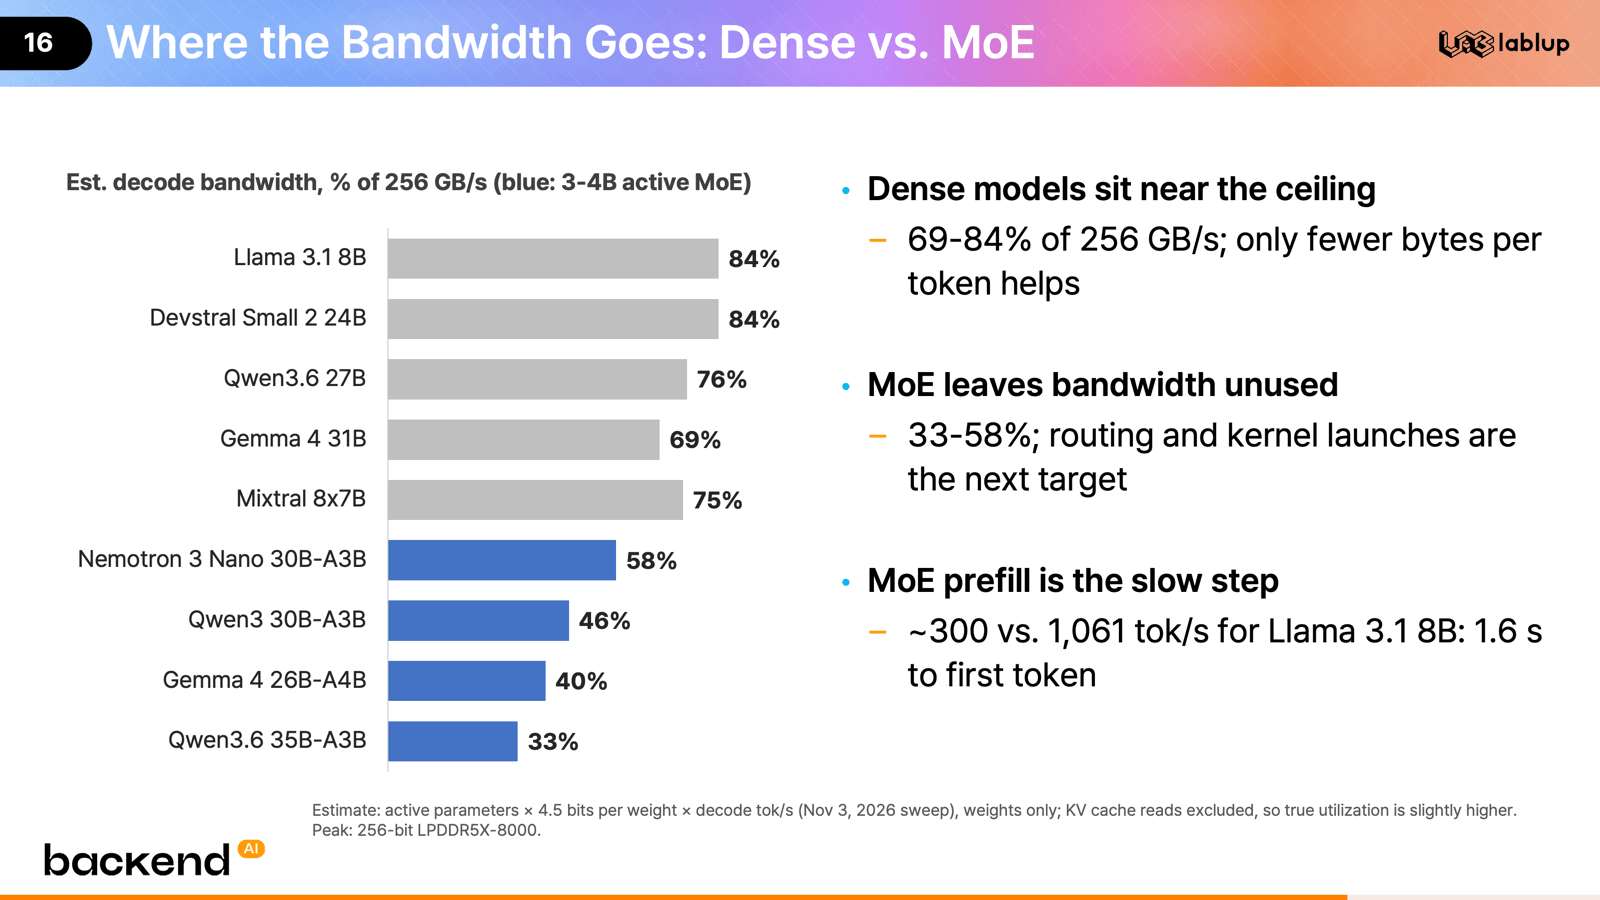
Dense 모델은 이론 최대치의 6984%를 쓰고 있습니다. KV 캐시 읽기를 빼고 계산한 값이므로 실제 사용률은 이보다 조금 더 높습니다. 여기서 더 빨라지려면 토큰당 읽는 바이트 수를 줄여야 합니다. 반면 활성 34B MoE 모델은 33~58%에 그칩니다. 대역폭에 여유가 있다는 뜻이며, 다음 최적화 대상은 전문가 라우팅과 커널 실행 오버헤드입니다.
MoE 모델의 약점은 prefill입니다. 약 300 tok/s로 Llama 3.1 8B의 1,061 tok/s에 크게 못 미치고, 512토큰 프롬프트에서 첫 토큰까지 1.6초가 걸립니다.
배치 서빙
mlxcel-server를 --parallel 4로 실행하고, 512토큰 프롬프트로 128토큰을 생성하는 요청을 동시에 1개, 4개 보냈을 때를 비교했습니다. 2개와 4개 요청은 프롬프트 캐시가 데워진 상태에서 시작했고, 합계 처리량에는 prefill이 포함되어 있습니다.
| 모델 | 합계 처리량 요청 1개 | 합계 처리량 요청 4개 | 배율 | 요청당 비용 |
|---|---|---|---|---|
| Llama 3.1 8B | 34 tok/s | 69 tok/s | 2.0배 | 요청당 디코드 41 → 19 tok/s |
| Qwen3 30B-A3B | 37 tok/s | 68 tok/s | 1.9배 | 첫 토큰까지 1.6 → 3.1초 |
동시 요청 4개에서 전체 처리량은 약 2배가 되지만, 개별 요청의 속도는 느려집니다. 혼자 쓰는 PC에서는 batch 1이, 여러 사용자나 에이전트가 함께 쓰는 환경에서는 배치 서빙이 적합합니다.
마치며
MLxcel 0.8부터는 MLX 기반의 단일 Rust 엔진으로 Apple Silicon, NVIDIA, AMD ROCm을 모두 지원합니다. 요청 경로에 Python 계층은 없습니다. Strix Halo에서는 테스트한 44개 모델이 모두 동작했고, dense 31B 모델은 메모리 대역폭 상한에 가까운 10.2 tok/s, 30B-A3B MoE 모델은 최대 76 tok/s로 디코드합니다.
Strix Halo 포팅을 통해 배운 점을 정리하면 세 가지입니다.
- 메모리 예산은 장치 풀 기준으로 잡아야 합니다. 운영체제가 보는 메모리와 GPU가 쓰는 메모리가 다른 구조에서는, 같은 "통합 메모리"라는 말 아래에서도 엔진이 가정을 바꿔야 합니다.
- 포팅하기 전에 프로파일링부터 해야 합니다. 호출 횟수가 아닌 GPU 시간이 우선순위를 정했고, 그 결과 처음 계획과는 거의 반대 순서로 커널을 옮겼습니다.
- 통합 메모리에서 가장 큰 이득을 보는 것은 MoE입니다. 활성 파라미터가 작은 MoE 모델은 같은 크기의 dense 모델보다 몇 배 빠르게 동작하고, 아직 대역폭에 여유도 남아 있습니다.
앞으로의 계획
가장 먼저 개선할 대상은 MoE입니다. 활성 34B MoE 모델은 아직 대역폭의 3358%만 쓰고 있어서, 전문가 라우팅과 커널 실행 오버헤드를 줄이면 디코드 속도를 더 높일 수 있습니다. 약 300 tok/s에 머물러 있는 MoE prefill도 함께 개선할 계획입니다.
다음은 지원 범위의 확대입니다. 지금의 ROCm 백엔드는 gfx1151에서만 검증된 실험적 단계입니다. 이후에는 Instinct 데이터센터 GPU의 CDNA 아키텍처로 지원을 넓히려 합니다. CDNA 3, CDNA 4 세대는 wave64와 MFMA, 하드웨어 FP8과 FP4를 갖추고 있어 별도의 커널 경로가 필요합니다. 반면 RDNA를 기반으로 다시 설계된 CDNA 5는 wave32를 쓰므로, Strix Halo용으로 작성한 커널을 출발점으로 삼을 수 있습니다.
사용해 보기
MLxcel은 Apache 2.0 라이선스의 오픈소스입니다. GitHub 저장소에서 소스를 받아 --features rocm으로 빌드하면 Strix Halo에서 바로 사용할 수 있습니다. 전체 변경 사항은 v0.8.0 및 v0.8.1 릴리즈 노트에서 확인할 수 있습니다. 이슈와 풀 리퀘스트는 언제든 환영합니다. 특히 gfx1151 이외의 AMD GPU에서 실행해 본 결과를 공유해 주시면 지원 범위를 넓히는 데 큰 도움이 됩니다.
MLxcel을 기업 환경의 AI 인프라에 도입하는 것에 관심이 있다면 래블업(contact@lablup.com contact@lablup.com)으로 문의해 주세요.
참고 자료
- lablup/mlxcel, mlxcel 릴리즈 노트
- AMD Ryzen AI Max+ 395 제품 페이지
- Tom's Hardware: Strix Halo 공개
- TechPowerUp: Strix Halo 칩렛 구성
- ServeTheHome: GB10 SoC 아키텍처 (Hot Chips 2025)
- PC Gamer: GB10과 MediaTek 협업
- Chips and Cheese: Grace Hopper
- Chips and Cheese: CDNA 5 인터뷰
- Electronic Design: Kaveri와 hUMA
- Apple M1 발표
- Tom's Hardware: NVIDIA RTX Spark
- Neowin: Copilot+ PC 요구 사양
- Stream HPC: RDNA와 CDNA의 차이
- ml-explore/mlx #2300: ROCm 백엔드 제안
- IREE: ROCm 배포 가이드
